1. 高見知英のAI音声解析チャンネル
  2. プログラミングの教え方:プロ..
プログラミングの教え方:プログラミング初学者の誤概念と学習上の困難に関する文献レビュー
2026-10-28 21:25

プログラミングの教え方:プログラミング初学者の誤概念と学習上の困難に関する文献レビュー

提供された文献群は、プログラミング初学者教育における誤解(ミスコンception)や認知的困難の構造、およびそれらを克服するための教育的アプローチを包括的に論じています。学習者が直面するつまずきは、構文的知識、概念的知識、戦略的知識の3つの領域に分類され、主に事前知識や不完全なメンタルモデルに起因することが示されています。これらの課題を解決するためには、可視化ツールの活用や明示的な指導方略の導入が不可欠です。さらに、単に誤りを指摘するだけでなく、概念的変化理論を統合して知識の変容プロセスを追跡することや、教員の**ペダゴジカル・コンテンツ・ナレッジ(PCK)**を向上させることが強調されています。

プログラミング初歩教育における誤解(Misconceptions)・学習上の困難・指導法に関する総合分析ブリーフィング・ドキュメント

エグゼクティブ・サマリー

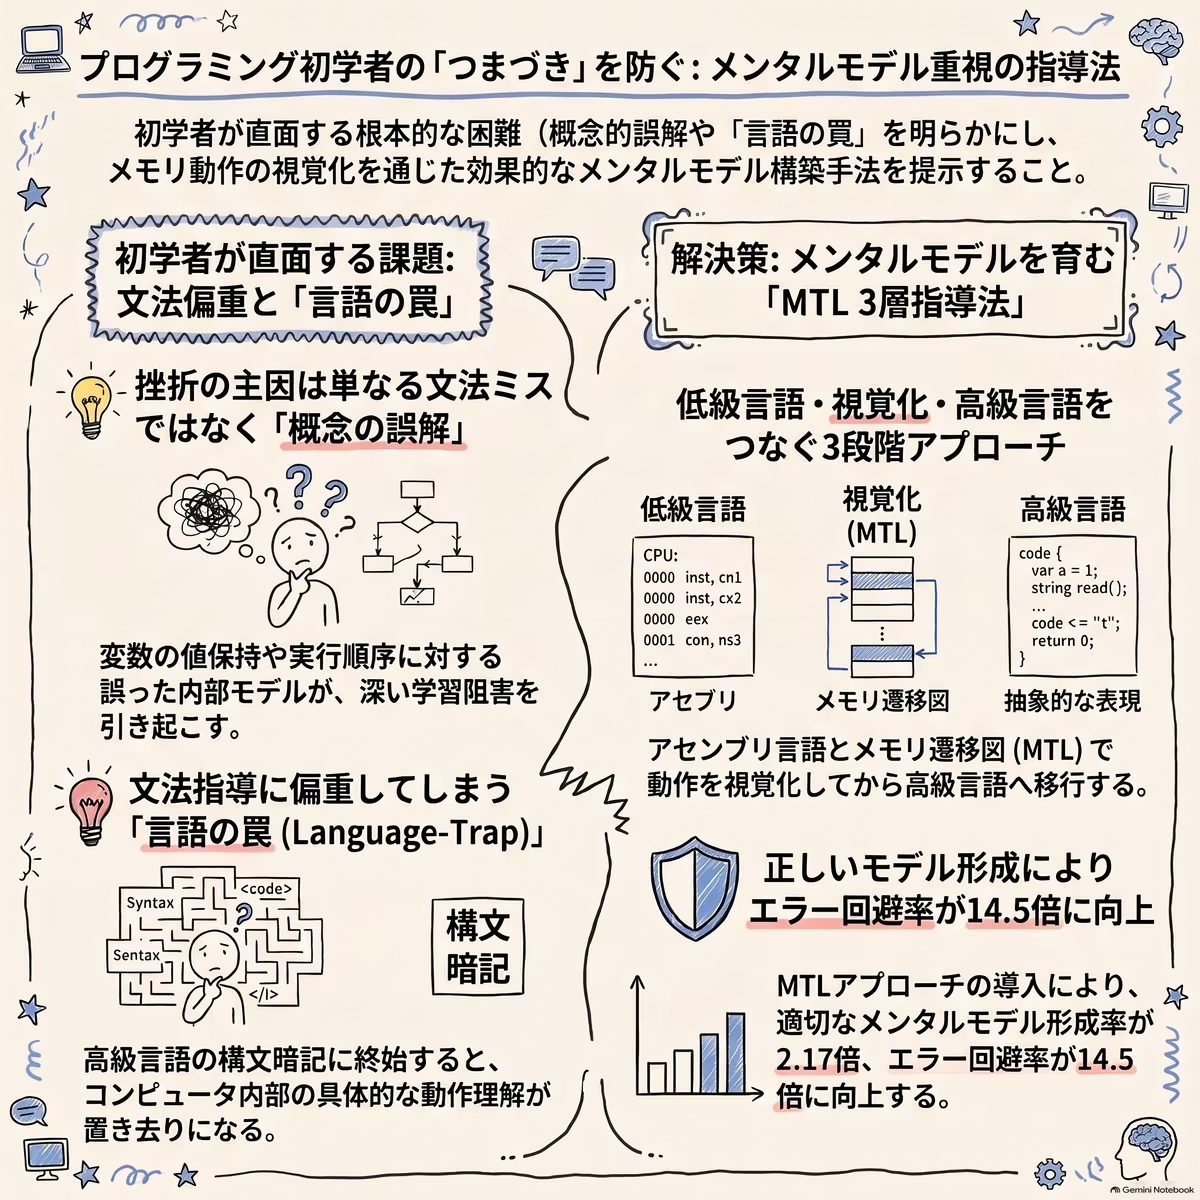
高度情報社会の進展に伴い、コンピュータサイエンス(CS)およびプログラミング教育の重要性が世界的に高まっている。米国における「CS for All」イニシアティブや日本の新学習指導要領(小学校2020年度、中学校2021年度、高等学校2022年度より年次進行で実施)にみられるように、初等・中等・高等教育の各段階でプログラミング教育の導入が加速している。しかしながら、プログラミング入門コース(CS1等)における学習者のドロップアウト率や挫折率は依然として高く、その主要因として**「学習者が抱く誤解(Misconceptions)とメンタルモデルの不全」および「文法機能の教授に偏重した従来の指導構造(言語の罠:Language-Trap)」**が指摘されている。

本ドキュメントは、プログラミング初学者が直面する概念的・文法的・戦略的困難の構造、それらを及ぼす認知要因、ならびに認知心理学・概念変化理論(Conceptual Change Theories)や最新の生成AI/LLM技術およびプログラム視覚化(Program Visualization: PV)を統合した革新的な指導アプローチについて、提供された文献に基づき総合的に分析・要約したものである。

本ドキュメントの主要な要点(Key Takeaways)

  1. 困難の3段階分類: プログラミング知識は「文法知識(Syntactic Knowledge)」「概念的知識(Conceptual Knowledge)」「戦略的知識(Strategic Knowledge)」の3領域に大別される。コンパイラ等で容易に検出できる文法エラーに対し、メンタルモデルの不備に起因する概念的誤解や戦略的欠如は潜在的かつ強固であり、深い学習阻害を引き起こす。
  2. 多角的な阻害要因: 誤解や困難は、高い認知負荷(Cognitive Load)、自然言語の日常的意味との干渉(メトニミーや論理演算子「and」「if」の混同)、既習の数学知識(等号 = の代入と方程式の混同)、コンピュータに対する過剰な知能視(「スーパーバグ」)、指導者のペダゴジカル・コンテント・ナレッジ(PCK)の不足や「エキスパートの盲点」など、多層的な要因によって発生する。
  3. 「言語の罠(Language-Trap)」からの脱却: 従来の教育アプローチは、高級言語(Java, C++, Python等)の文法機能(「Hello World」の出力や複数ループ構文の網羅)の教授に偏重し、コンピュータ内部のメモリ動態(メンタルモデル)の形成を軽視してきた。この「言語の罠」が高認知負荷と負の学習モメンタム(Negative LEM)を生む原因となっている。
  4. 「MTL 3層アプローチ」の実証的効果: 低レベル言語(アセンブリ言語)によるレジスタ/メモリ動作の提示、Memory Transfer Language(MTL)によるメモリ視覚化(物理モデルおよびRAM図)、および高級言語のコード例を組み合わせた「MTL 3層アプローチ(MTL Three-Tier Approach)」は、初学者の正当なメンタルモデル形成率を2.17倍に高め、代表的なプログラミングエラーの回避率を14.50倍向上させることが実験的に実証されている。
  5. 概念変化理論と最新AIフィードバックの融合: 認知科学の「Knowledge-as-theory(理論としての知識)」および「Knowledge-as-elements(要素としての知識/p-prims)」モデルを取り入れ、単にエラーを指摘・修正するのではなく、学習者の直感的知識や誤解の変容プロセスに寄り添う指導設計が不可欠である。さらに、AST(抽象構文木)静的解析とLLMを組み合わせたソクラテス的フィードバック(例:StructDiag-AI)や、指導者のTPACK/PCK推定モデルなど、高度なAI技術の導入が新たな解決策として提示されている。

1. プログラミング初学者における誤解(Misconceptions)と困難の分類

プログラミングの学習プロセスは、言語機能の習得からドメイン概念の理解、そして新規問題解決への応用へと至る「一連の認知的な達成(Chain of Cognitive Accomplishments)」として捉えられる。研究(Mayer & Fay, 1987; McGill & Volet, 1997等)に基づき、学習者が直面する困難は以下の3つの知識領域に整理される。

学習者のプログラミング知識の分類
 ├── 文法知識 (Syntactic Knowledge): ルール・記号・構文の記憶 (比較的修復が容易)
 ├── 概念的知識 (Conceptual Knowledge): 内部動作・構造・原理の理解 (誤解/メンタルモデルの中心)
 └── 戦略的知識 (Strategic Knowledge): 企劃・コード記述・トレース・デバッグ (高次の問題解決)

1.1 文法知識(Syntactic Knowledge)における困難

文法知識とは、プログラミング言語の基本事実、規則、構文ルール(例:Javaにおける文字列の二重引用符、文末のセミコロン等)に関する知識である。

  • 代表的なエラー・困難: 括弧・ブラケット・引用符のミスマッチ、宣言されていないシンボル(Irresolvable symbols)、セミコロンの欠落、不適切なブール式、比較演算子(==)と代入演算子(=)の誤用。
  • 特徴: 大規模データ分析(BlueJ/Blackboxプロジェクト等)において最も頻繁に観察されるが、コンパイラや現代のIDEによるエラーメッセージで容易に検知・修正が可能なため、比較的小さい表面的な問題とされる。

1.2 概念的知識(Conceptual Knowledge)における誤解

概念的知識とは、プログラミング構文や原理が「コンピュータ内部でどのように動作・処理されているか」に関する理解を指す。「誤解(Misconceptions)」の本質は、この概念的理解の誤りや不完全さにある。

概念領域初学者の代表的な誤解・困難
変数と代入・変数は同時に複数の値を保持できるという誤解。 ・代入の順序性の誤解(A = 5 と 5 = A を同等とみなす)。 ・変数名の英単語の意味が保持する値に影響する(例:largest という変数名には常に大きな値が入る)という誤用。 ・変数のスコープ(ローカル変数とグローバル変数)の不適切な混同。
入出力操作・データがどこから来てどこへ格納されるかの不解。 ・画面出力メッセージ(例:The value of X is 1)によって変数の値自体が変更されるという誤解。
条件分岐・if ブロックと else ブロックの両方が実行されるという誤解。 ・if の条件が偽の場合、プログラム全体の実行が停止するという誤解。
繰り返し(ループ)・ループのスコープや繰り返し実行される行数の誤認(例:プリント文のみが繰り返されると錯覚)。 ・for ループと while ループの相対的優位性に関する偏見(概念的同等性の不理解)。
プログラム実行順序・コードが順次実行(Sequential execution)されることの不解。 ・ループ内の条件文は、ループ外で条件が満たされた際にも常時発動するという誤解。 ・3行による値の入れ替え(Swap)処理の理解不能。 ・関数/メソッドにおける引数(パラメータ)と戻り値(Return value)の授受の混乱。
オブジェクト指向(OOP)・クラスとオブジェクト/インスタンスの関係の誤認(例:クラスはオブジェクトの集合体、あるいはオブジェクトはクラスの部分集合であるという誤解)。 ・main メソッドのローカル変数に参照オブジェクトからアクセス可能であるという誤解。 ・参照(Reference)と参照代入における属性コピーの混同。

1.3 戦略的知識(Strategic Knowledge)における困難

戦略的知識とは、問題解決のために文法知識と概念的知識を組み合わせ、プログラムの計画(Planning)、記述(Writing)、トレース(Tracing)、およびデバッグ(Debugging)を行う高次の知識(条件付知識)である。

  • 課題と decomposition(問題分解)の失敗: 課題の文脈を理解し、解法プロセスを分解することへの困難。
  • 境界条件の無視: 処理の適切な境界条件や例外的なケース(ゼロ除算ガード等)の検証不足。
  • 変数の役割(Roles of Variables)の不解: 集計(sum)やカウント(count)変数の初期化・更新パターンの失敗。
  • コードブロックの結合(Pattern Interleaving)の障害: 複数のアルゴリズムパターンを組み合わせる(インターリーブする)際、結合できずに単純に連結(Concatenate)してしまう傾向。
  • トレースとデバッグの局所性: 全体構造の理解に基づかず、コードを1行ずつ局所的(Local manner)にのみトレースする傾向。デバッグにおける本質的困難は「エラーの修正」そのものよりも「プログラムの理解とバグ位置の特定」にある。

2. 誤解および学習阻害を引き起こす主要要因

初学者が直面する困難や誤解は単一の要因ではなく、認知メカニズム、既習知識、外部環境、指導法などの複合的な影響によって生じる。

誤解および困難の発生要因
 ├── 1. タスクの複雑性と認知負荷 (Cognitive Load & Negative LEM)
 ├── 2. 自然言語の干渉 (Natural Language & Metonymy)
 ├── 3. 既習の数学知識の干渉 (Prior Math Knowledge)
 ├── 4. 不完全なメンタルモデル / ノーション・マシン / スーパーバグ (Flawed Mental Models)
 ├── 5. 不十分なパターンと認知発達段階 (Neo-Piagetian Stages & Fragile Knowledge)
 ├── 6. 開発環境・プログラミング言語の特性 (Environmental Factors)
 └── 7. 指導者の知識・指導戦略 (Instructors' PCK & Expert Blind Spot)

2.1 タスクの複雑性と認知負荷(Cognitive Load & LEM)

プログラミングは多数の新しい概念、構文ルール、論理的推論を同時に処理する必要があり、作業記憶(Working Memory)への負荷が極めて高い。

  • ワーキングメモリのオーバーフロー: タスクが複雑化すると、ワーキングメモリから必要な情報が喪失し、基本記号の欠落や文法エラーが急増する(Anderson & Jeffries, 1985)。
  • 学習エッジ・モメンタム(Learning Edge Momentum: LEM): 概念間の相互依存性が高いため、初期段階での理解の欠如(負のLEM)は不快感と挫折感を自己強化させ、ドロップアウト率の上昇に直結する(Robins, 2010)。

2.2 自然言語の干渉(Natural Language Interference)

日常言語の文法や意味論が、プログラミング言語のコマンド解釈を歪める現象。

  • 単語の意味の乖離: 日常会話の「if」(〜するときはいつでも待機する)や「and」(並列的接続詞)を、プログラミングの条件判定やブール演算子として誤認する。
  • メトニミー(換語)の適用: 人間同士の会話のように「コンピュータが文脈や関連性から意図を推論してくれる」と錯覚し、関連属性の名前で要素を直接参照しようとする(Miller, 2014)。
  • 英語力の影響: 英語非母語話者の学習において、英語力(English Ability)がプログラミング学習の成功と強く相関することが示されている(Qian & Lehman, 2016)。

2.3 既習の数学知識の干渉(Prior Math Knowledge)

長年親しんできた代数(Algebra)のルールとプログラミング記号との衝突。

  • 代数方程式と代入の混同: 数学の等式と同等に捉えるため、x = x + 1 の意味が理解不能となる。また、事前宣言なしで変数を使用するエラーを誘発する。
  • データ型と精度の相違: 数学における無限の精度・範囲と異なり、コンピュータメモリ上の有限性(型制限)や、整数除算(例:1 / 2 = 0)の概念的ギャップが理解の阻害要因となる。

2.4 不完全なメンタルモデルと「スーパーバグ(Superbug)」

メンタルモデルとは、コードの背景にある非表示の処理やコンピュータ内部動作に関する内部表象である。

  • ノショナル・マシン(Notional Machine)の歪み: プログラムを実行する理想化されたコンピュータ動作モデルの不全。
  • スーパーバグ(Superbug): コンピュータに人間のような知性や意図を汲み取る能力があると信じ込み、「コンピュータが意図通りに解釈して実行してくれる」と考える根深い誤解(Pea, 1986; Sleeman et al., 1986)。

2.5 プログラミングパターンの不完全さと認知発達段階

知識が統合されていない「脆い知識(Fragile Knowledge)」の状態では、抽象的推論が不可能となる。ネオ・ピアジェ派の段階説(Lister, 2011)によると、初学者の成長段階は以下のように区分される。

  1. 感覚運動期(Sensorimotor): コードの簡単なトレースが安定して行えない。
  2. 前操作期(Preoperational): コードのトレースや記述は部分的に可能だが、プログラム全体としての目的やパーツ間の関係(「木を見て森を見ず」)が見えない。
  3. 具体的操作期(Concrete Operational): 全体と部分の関係を理解しパターンを形成するが、抽象的推論は既知の文脈に限定される。
  4. 形式的操作期(Formal Operational): 未知の状況でも論理的・体系的・抽象的に推論し問題解決できる(エキスパートの段階)。

初学者の多くは前操作期にとどまっており、単に大量のコードを書かせるだけでは具体的操作期へ移行できない。

2.6 開発環境および言語特性(Environmental Factors)

  • 演算子の多義性: + 記号が数値の加算、文字列の連結、数値と文字列の結合などに重複使用(オーバーロード)されることが初学者の混乱を招く。
  • 暗号的なコンパイラメッセージ: 「cannot find symbol」などの不明瞭なエラー出力は、エラー修正プロセスを阻害し挫折感を高める。

2.7 指導者の知識と「言語の罠(Language-Trap)」

  • 指導者のPCK不足とエキスパートの盲点(Expert Blind Spot): 専門知識を持つ教員であっても、初学者がなぜつまずくのかを理解できず(Brown & Altadmri, 2014; Guzdial, 2015)、適切な「理由」ではなく機械的な「規則」のみを教授してしまう。また、「変数は箱である」といった不適切な比喩(Analogy)の多用が誤解を定着させる。
  • 「言語の罠(Language-Trap)」の存在(Mselle, 2025): 多くのシラバス、教科書、試験が、メンタルモデルの構築を排除して「言語機能(文法・構文)の網羅」に極度に偏重している現状。例えば、最初のレッスンで変数宣言・入力より前に cout << "Hello World"; などの出力文を教える慣行や、本質的に同一のメンタルモデルを表す3つのループ構文(for, while, do-while)に同等の時間を割く指導構造が、高認知負荷と負のLEMを引き起こしている。

3. 困難・誤解を解消するための指導法および学習ツール

初学者の誤解や困難に対処するため、多角的な教育的介入、学習ツール、および最新技術が開発・適用されている。

3.1 効果的な指導法および学習戦略

  • ** worked-out examples(作成済みサンプルコード)の活用**: 転移指向のタスクやモデルコードの読解・トレース・解説を通じて、認知負荷を軽減し、全体的なプログラム理解力を養う。
  • 戦略およびパターンの明示的指導:
    • パターン指向指導(Pattern-Oriented Instruction: POI): 問題分解と解法構築のスキーマを形成させる。
    • 変数の役割(Roles of Variables): 変数の使用パターン(Fixed value, Stepper, Most-recent holderなど10個の役割で全変数の99%をカバー)を明示的に教授し、深層的なエラーを削減する(Sajaniemi & Kuittinen, 2005)。
  • コンセプト・インベントリ(Concept Inventory: CI): 概念の理解度を客観的に評価・測定するための診断テスト。
  • ピア・インストラクション(Peer Instruction: PI): 「個人解答 → 仲間との議論 → 再解答」のプロセスを通じて概念的理解を深め、不合格率を大幅に低下させる。

3.2 視覚化ツールおよびプログラミング環境

  • 構文エラーの予防・軽減環境: ドラッグ&ドロップによるビジュアルプログラミング環境(Scratch等)や、自然言語風のプログラミング言語(MOOSE等)。
  • プログラム視覚化(Program Visualization: PV)ツール:
    • Online Python Tutor: Pythonコードの実行過程をステップバイステップで視覚化。
    • Greenfoot: オブジェクト指向の概念を視覚的に提示。
    • UUhistle / Celiot: ノショナル・マシンの動作やメモリ構造をアニメーション表示し、フィードバックを提供。
  • デバッグ支援ツール: ユーザーに優しい詳細なエラーメッセージを提供するツール(Decaf)や、「なぜこの動作が起きたのか/起きなかったのか」を問う質問型デバッグインターフェース(Whyline)。
  • 自動評価・知的チュートリアルシステム(ITS): 大規模な学習データ(Blackbox等)を活用し、リアルタイムのパーソナライズされたヒントや事前ヒントを提供する。

3.3 革新的教授法:「MTL 3層アプローチ(MTL Three-Tier Approach)」

Mselle(2025)は、「言語の罠」を回避し、正当なメンタルモデルを早期に定着させるアプローチとして**「MTL 3層アプローチ」**を提唱・検証した。

MTL 3層アプローチの構造
 [第1層] 低レベル言語 (アセンブリコード: MOV, ADD等)
    ↓  (レジスタ・メモリ動作の直接的・具体的理解)
 [第2層] Memory Transfer Language (MTL) PV & 物理モデル
    ↓  (物理的容器/石粒、RAM矩形図によるメモリ変容の可視化)
 [第3層] 高レベル言語 (C++, Java, Python等の高級言語コード)

実証実験の結果(Mselle, 2025)

  • 実験1(メンタルモデル形成率の検証、N = 2,322):
    • 統制群(従来指導)のエラー率:61.89%(687 / 1,110名)
    • 介入群(MTL 3層アプローチ)のエラー率:28.47%(345 / 1,212名)
    • 結果: 相対リスク(RR)は 2.17(p < 0.0001)。介入群の学習者は正当なメンタルモデルを形成する確率が 2.17倍 高かった。
  • 実験2(期末試験における代表的エラー回避率の検証、N = 1,200):
    • 統制群のエラー発生率:68.50%(411 / 600名)
    • 介入群のエラー発生率:14.50%(87 / 600名)
    • 結果: 相対リスク(RR)は 14.50(p < 0.0001)。介入群の学習者は一般的なプログラミングエラーを回避する確率が 14.50倍 高かった。

3.4 デバッグ支援と最新AI/LLM技術の適用(2026年の動向)

近年、生成AI(GenAI)や大規模言語モデル(LLM)の教育利用が進む中で、単に正解コードを提示するのではなく、学習者の誤解を診断・解消するための高度な手法が開発されている。

  • StructDiag-AI(Sharma, 2026): 抽象構文木(AST)の静的解析によって構造的バグ(ループの誤入れ子、到達不能な再帰枝等)を特定し、LLMプロンプトと統合して段階的なソクラテス的ヒントを生成するフレームワーク。従来コンパイラと比較してバグ解決率を 38.4% 向上させ、無制約LLMと比較して長期的な概念定着率を 24.1% 改善した。
  • CoT構造化GenAIフィードバック(Zhu et al., 2026): 思考の連鎖(Chain-of-Thought: CoT)を用いたフィードバックにより、デバッグパフォーマンス向上と認知負荷軽減を両立。
  • LLM生成フィードバックの診断精度の課題(Zhao et al., 2026): 商用LLMによる自動採点・フィードバックは一見詳細に見えるものの、実際の学習者の誤解を検出する割合は低く(人間教員の15〜31%に対しLLMは5〜7%)、トーンが過剰にポジティブで診断的役割を果たしきれていない点が指摘されている。
  • マルチアウトプット・グラディエント・ブースティングによるTPACK推定(Duisenova et al., 2026): コンテナ実行環境のログや打鍵系列、リフレクションテキストから、教員候補者の技術知識(TK)・内容知識(CK)・ペダゴジカル・コンテント・ナレッジ(PCK)を多次元的に推定する技術。

4. 概念変化理論(Conceptual Change Theories)の応用

自然科学や数学教育で発展してきた「概念変化理論」をプログラミング教育に統合することで、単なるエラーカタログの作成を超えた「知識獲得と誤解の進化プロセス」の解明が可能となる。

概念変化理論の主要アプローチ
 ├── 1. Knowledge-as-theory (Posner et al.)
 │      └─ 認知葛藤 (Cognitive Conflict) により既存のナイーブ理論を破棄・置換
 │         条件: Intelligible (理解可能), Plausible (妥当), Fruitful (有効)
 ├── 2. Knowledge-as-elements (diSessa)
 │      └─ 断片的な知識要素 (p-prims) の再構築・進化プロセス。文脈依存性を強調
 └── 3. Framework Theory (Vosniadou)
        └─ 既習知識に基づく「合成モデル (Synthetic Models)」等の漸進的中間状態の形成

4.1 理論的視点

  1. Knowledge-as-theory(理論としての知識): 学習者は一貫した「ナイーブな理論構造」を持っており、それが誤解を生むとする。概念変化は革命的な理論の置換であり、**認知葛藤(Cognitive Conflict)**を起こさせることが重要とされる。新しい概念は「理解可能(Intelligible)」「妥当(Plausible)」「有効(Fruitful)」でなければならない(Posner et al., 1982)。
  2. Knowledge-as-elements(要素としての知識): 学習者の知識は直感的・断片的な要素(p-prims: 現象学的原始概念)の集まりであるとする(diSessa, 1993)。概念変化はこれら要素の再構成・洗練の進化的プロセスであり、学習者の直感的知識は排除すべき対象ではなく「構築の資源」と捉えられる。
  3. Framework Theory(フレームワーク理論): 概念変化は漸進的であり、指示を受けた学習者はしばしば科学的理解に至る中間段階として**「合成モデル(Synthetic Models)」**を形成する(Vosniadou, 1994)。

4.2 プログラミング教育への示唆

  • 直感的知識の価値の認容: 学習者の直前知識や誤解を単なる「障害」として排除するのではなく、正当な概念へ再構成するための「教育的リソース」として扱う必要がある。
  • 合成モデルと軌跡の追跡: 学習者は初期知識と目標知識の間に様々な中間状態(合成モデル)を形成する。リアルタイムデータ(Blackboxデータセット等)を用いたマイクロジェネティック分析により、学習者が正しい概念へと移行する軌跡を解明することが求められている。

5. 知識領域別の困難・要因・解消戦略の総合統合

以下の表は、 Qian & Lehman(2017)および Mselle(2025)の研究成果を統合し、プログラミング知識の3領域における代表的困難、主要要因、および具体的な解消戦略・ツールをまとめたものである。

知識領域困難の代表例主要な関連要因解消のための戦略・ツール・方法論
文法知識 (Syntactic)・括弧、ブラケット、引用符のミスマッチ ・代入演算子と比較演算子の誤用(例:if (a = true)) ・宣言されていない変数の使用、セミコロン欠落・タスクの複雑化による認知負荷の増大(作業記憶からの情報漏れ) ・開発環境によるエラー強調の不足・高度なコードエディタ / ビジュアル環境(Scratch等)による即時ハイライト・入力強制 ・Decaf等によるユーザーに優しい詳細エラーメッセージの提示
概念的知識 (Conceptual)・変数と代入文の動作誤解(値の重複保持、順序の無視) ・条件文(両ブロック実行の錯覚) ・ループ(繰返し範囲や実行回数の誤認) ・クラスとオブジェクトの関係の誤認 ・プログラムの順次実行・メモリ退避の誤認・日常言語(if, and 等)の意味干渉 ・代数学の既習知識(等号の解釈)の干渉 ・不完全なノショナル・マシン / スーパーバグ ・教員のPCK不足および不適切な比喩(箱モデル等) ・「言語の罠」(構文教授への偏重)・「MTL 3層アプローチ」(アセンブリ言語+MTL物理モデル/RAM図+高級言語)の導入 ・Python Tutor, Greenfoot, UUhistle 等のPVツールによるメモリ状態の可視化 ・概念変化理論に基づく認知葛藤の誘発と合成モデルの補正 ・コンセプト・インベントリ(CI)およびピア・インストラクション(PI)
戦略的知識 (Strategic)・適切なループ構造の選択失敗 ・ゼロ除算ガードなどの例外処理の欠落 ・問題分解の失敗、アルゴリズムパターンのインターリーブ不能 ・効果的なテスト・デバッグ戦略の欠如(局所的トレース)・文法・概念知識の断片化(「脆い知識」) ・問題解決パターンや戦略の明示的指導の欠如 ・ネオ・ピアジェ段階における前操作期にとどまる認知状態・作成済みサンプルコード(worked-out examples)の読解・トレース・説明の強制 ・変数の役割(Roles of Variables)およびパターン指向指導(POI)の明示的教授 ・Whyline等の質問型デバッグ環境の利用 ・StructDiag-AI等のAST解析+LLMによるソクラテス的フィードバック

6. 結論と教育政策・実践への提言

プログラミング教育の世界的拡大に伴い、初学者に対する教育の質的改善は緊急の課題である。本ブリーフィングドキュメントの分析に基づき、以下の3点を今後の研究・実践における重点提言として提示する。

  1. 既存ツール・アプローチの普及(Dissemination)と長期効果の検証: これまで多数の優秀な視覚化ツールや指導アプローチが開発されてきたが、開発機関以外への普及は限定的であった。今後はBlueJ/Blackboxのような成功事例に倣い、開発されたツールや指導アプローチ(MTL 3層アプローチ等)の広範な普及を推進し、その長期的効果を検証する必要がある。
  2. 概念変化理論を統合した研究の進展: 単に誤解やエラーをカタログ化・統計化する段階から脱却し、概念変化理論(Knowledge-as-theory / Knowledge-as-elements)を取り入れるべきである。大規模な学習履歴データやAIアナリティクスを活用して、学習者のナイーブな理解がどのように変化・進化(合成モデルの推移)していくのか、その動的なプロセスを解明する研究が求められる。
  3. 教員のペダゴジカル・コンテント・ナレッジ(PCK)の育成と向上: プログラミング指導の成否は、教員自身のPCK(学習者の誤解に関する知識、エキスパートの盲点の自覚、効果的な視覚化・指導ツールの活用能力)に大きく依存する。教員が学習者の誤解を「排除すべき欠陥」ではなく「概念構築のための貴重なリソース」として捉え直し、メンタルモデルを中心とした指導を実践できるよう、教員養成および研修プログラムの拡充(TPACK/PCKの定量的評価等)を推進することが不可欠である。

感想

まだ感想はありません。最初の1件を書きましょう!

サマリー

プログラミング初学者が挫折する背景を、構文・概念・戦略の3種類の知識から整理する。特に、変数を箱とみなす比喩や、数学の等号をそのまま適用する誤解など、既存のメンタルモデルが概念理解を妨げる仕組みを説明する。高水準言語が内部のメモリ動作を隠す「言語の罠」に対して、物理モデル、MTLダイアグラム、アセンブリ、高水準言語を組み合わせるMTL 3層アプローチが紹介され、正しいモデル形成率やエラー回避率の向上が語られる。後半では、生成AIにコードを任せるだけでは抽象的思考が育たないという問題を取り上げ、AST解析とソクラテス的ヒントで思考のバグを診断するStructDiag-AIや、教員の指導効果を分析するAIに触れる。最後に、プログラミング教育の目的をコード作成に限らず、既存の思い込みを疑い、メンタルモデルを更新する訓練として位置づける。

プログラミング学習の3種類の知識
スピーカー 1
あのちょっと想像してみてください。 あなたがえっと全く新しい言語を学ぼうとして見知らぬ異国に降り立ったとしますよね。
はいはい。語学留学みたいな感じですね。 その国の言葉は見慣れた英単語でできているからなんだか簡単そうに見えるんですよ。
でもなぜか文法は私たちが中学校で習った数学の代数、あのルールで動いているんです。
スピーカー 2
ああそれは英単語なのに数学のルールですか。 かなり頭が混乱しそうですね。
スピーカー 1
そうなんです。しかもちょっとでも言い回しを間違えるたびに、現地の人は何が間違っているのかを優しく教えてくれないばかりか、全く意味不明な暗号のような言葉で冷たくエラーを突きつけてくるんですよ。
スピーカー 2
まあそれは非常にストレスフルな状況ですよね。 単純な言語の壁というより、なんというか世界の物理法則そのものが変わってしまったような根本的な認知のズレを感じるはずです。
スピーカー 1
もう完全にパニックになりますよね。 でも実はこれ単なるSFの話でもとっぴな思考実験でもないんです。
世界中でプログラミングを学び始めたばかりの人たちが、今この瞬間にも直面している現実なんですよね。
スピーカー 2
そうですね本当にその通りだと思います。
よくプログラミングはこれからの時代の必須スキルだなんて言われて久しいじゃないですか。
スピーカー 1
でも同時に驚くほど多くの人がこの最初の壁を越えられずに挫折してしまいます。
今回の深掘りではこのなぜ私たちはプログラミング学習でここまでつまずくのかという大きな謎を解き明かしていきたいと思います。
スピーカー 2
日本でも文部科学省が学習指導要領を改定してプログラミング教育を強力に推進していますよね。
ただ現場では依然として多くの課題が残されているのが現状です。
スピーカー 1
そうなんですよ。そこで今回は学習者のつまずきを分析した包括的な学術レビューからメンタルモデル構築に関する最新の論文、
さらには2026年のAIを用いた最新の教育支援システムに関する研究まで様々な資料を掛け合わせて分析してみました。
スピーカー 2
なかなか幅広いそして最先端の資料ですね。
スピーカー 1
ここから見えてきたのは単に高度の暗記を強いる教育から人間の思考の構造そのものをガイドするアプローチへの劇的なパラダイムシフトなんです。
リスナーのあなたも今後何か新しいスキルを身につけようとする際になぜ過去の知識が邪魔をするのかすごく大きなアハ体験になると思いますよ。
スピーカー 2
非常にエキサイティングなテーマですね。最新の研究を読み解くことで私たちが新しい概念を学ぶときに脳内で一体何が起きているのかが鮮明に見えてきますから。
スピーカー 1
では早速根本的な疑問から行きましょう。少しひも解いてみたいんですが、なぜあんなに多くの人がプログラミングで挫折するんでしょうか。
資料にあったチエンとリーマンの研究によるとプログラミングに必要な知識は大きく3つの階層に分けられるそうですね。
スピーカー 2
そうです。ここを整理すると問題の輪郭がすごくはっきりするんですよ。
スピーカー 1
まず一つ目は構文的知識、シンタクティックと呼びますが、これは文末にはセミコロンが必要だとか、ここはカンマで区切るといった言語の表面的な文法ルールのことです。
あーなるほど、文法ですね。
はい。そして2つ目が概念的知識、コンセプチュアルです。ループ処理はどう動くのかとか、メモリの中で何が起きているのかというシステム全体の仕組みの理解ですね。
スピーカー 2
ふむふむ。
スピーカー 1
最後に3つ目が戦略的知識、ストラテジックです。これは、先の2つを駆使して目の前の新しい課題をどう解決するかという計画を立てる能力になります。
スピーカー 2
でも初心者が一番苦労しているのって、ぱっと見は一つ目の構文的知識に思えるんですよ。あの括弧を閉じ忘れてプログラムが動かないみたいな単純なミスに何時間も悩まされたりしますから。
スピーカー 1
ええ、確かにそう見えますよね。初心者の画面には常にあの忌まわしい構文エラーの赤線が引かれていますから、そこが最大の壁だと錯覚しがちなんです。
スピーカー 2
錯覚ですか?
そうなんです。研究が指摘している真の挫折の原因はそこではありません。構文エラーなんて今の優秀なエディターなら自動で修正してくれますからね。
既存のメンタルモデルが生む誤解
スピーカー 1
学習者が本当に深い沼にはまり、最終的に学習を諦めてしまうのは、2つ目の概念的知識、つまりコンピュータの内部動作に対する不正確なメンタルモデルが原因なんです。
スピーカー 2
なるほど、頭の中にある仕組みのイメージが現実のコンピューターの動きとずれているということですね。
スピーカー 1
まさにその通りです。
資料の中で特に面白いなと思ったのが、プログラミングの授業でよく使われるアナロジー、つまり比喩が実は罠になっているという指摘なんです。
スピーカー 2
例えば、変数は何でも入れられる物理的な箱のようなものだって教わりますよね。
スピーカー 1
教育現場で非常によく使われる古典的な教え方ですね。イメージしやすいので導入としては優れているように見えるんですが。
でもこれが後々大きな足枷になるんですよね。箱という現実世界のアナロジーを信じ込んでしまうと、無意識のうちにリンゴを入れながら同時にみかんも入れておける、みたいな感覚になってしまうんです。
スピーカー 1
現実の箱なら当然そうなりますからね。
スピーカー 2
でも実際のプログラミングの変数は基本的には一度に一つの値しか保持できません。新しい値を入れたら古い値は上書きされて消えてしまう。
この初期に植え付けられた箱のイメージのせいで複雑なコードになったときに同時に複数の値が存在していると勘違いして論理が破綻してしまうんですよね。
スピーカー 1
ここで非常に興味深いのはですね、その現象が認知科学の視点から見ると非常に理にかなっているという点なんです。
初心者は真っ白なキャンバスに新しい知識を描いているわけではないんですよ。
スピーカー 2
と言いますと?
彼らはすでに現実世界の物理法則や日常生活から得た直感的な思い込みを持っています。
スピーカー 1
専門用語ではこれを現象学的原子概念、PPRIMSと呼ぶんですが、この既存の知識があまりにも強力なためコンピュータ特有の概念に書き換えることが極めて難しくなっているんです。
スピーカー 2
つまり私たちが今まで生きてきて培った既存の知識そのものが学習の邪魔をするってことですよね。
数学・自然言語・擬人化の罠
スピーカー 2
でも待ってください。例えば数学がすごく得意な人や英語なんかの語学が堪能な人っていますよね。
スピーカー 1
たくさんいますね。
スピーカー 2
彼らはすでに高度な論理的思考力を持っているわけだから、プログラミングも自然とスムーズに得意になるはずですよね。
スピーカー 1
それが一筋縄では行かないところなんです。むしろ数学や英語の知識があるからこそ陥る罠があるんですよ。
これを負の転移と呼ぶんですが、例えば数学の代数とプログラミングの変数は似て非なるものなんです。
スピーカー 2
どう違うんでしょうか。
スピーカー 1
数学の授業では方程式を解く前にこのxは整数ですなんてわざわざ宣言する必要はありませんよね。
スピーカー 2
確かにいきなり数式を書き始めますね。
スピーカー 1
さらに決定的なのがプログラミングの初期で必ず登場するxイコールxプラス1という記述です。
これを数学の脳で解釈しようとするとどうなると思いますか。
スピーカー 2
あ、xとxに1を足したものが等しい。そんなのおかしい。解なしだって脳が混乱するわけですね。
スピーカー 1
その通りです。数学におけるイコールは左右が等しいという状態を表しますが、プログラミングにおけるイコールは右側の計算結果を左側の変数に代入するというアクション、つまり動的な処理なんです。
同じ記号を使っているのに意味が全く違うんですよ。
スピーカー 2
なるほど。英語の知識も同じような罠があるんでしょうか。
スピーカー 1
&という単語は日常会話では緩い接続詞ですが、プログラミングでは厳密な条件を縛る論理演算子です。
日常の感覚でもしA&Bならと書いてしまうと、コンピューターの厳格な解釈と衝突してしまいます。
さらに、Pという研究者が提唱しているスーパーバグという概念も興味深かったんですよ。
人間って無意識のうちにコンピューターを擬人化してしまうんですよね。
スピーカー 1
これくらい書けばあとは文脈を読んで適当に処理してくれるだろうって人間に話しかけるような期待をしてしまう。
コンピューターには人間のような常識や知能があると暗黙のうちに仮定してしまう。これがスーパーバグです。
結局のところ、私たちが日常的に使っている数学や自然言語、物理法則のメンタルモデルをそのまま持ち込もうとするから、システムと衝突して挫折してしまうわけです。
スピーカー 2
私たちの脳の初期設定そのものがプログラミングの概念と相性が悪いことはよくわかりました。
高水準言語の「言語の罠」
スピーカー 2
でもここからが本当に面白いところなんですが、それがわかっているならなぜ現代の教育はそのメンタルモデルのズレを防げないんでしょうか。
今のプログラミング言語って昔に比べてずっと簡単になっていますよね。
スピーカー 1
そこがですね、ムセレの2025年の研究が突き止めた非常にパラドックスに満ちた発見なんです。
彼はこれを言語の罠、ザ・ランゲージトラップと呼んでいます。
スピーカー 2
言語の罠ですか?
スピーカー 1
はい。実は学習を簡単にするために導入されたはずの、現代の高水準言語そのものが正しいメンタルモデルの構築を妨げる最大の原因になっているというんです。
スピーカー 2
普通プログラミングを学ぶときって、PythonやJava、C++のような人間に読みやすい高水準言語から始めますよね。
プリント、ハローワールドって書けばすぐに画面に文字が出てくるから楽しいですし、それが罠だというんですか?
スピーカー 1
高水準言語の最大のメリットは、メモリの割り当てやデータの物理的な移動といったコンピュータ内部の泥臭い処理をすべて隠蔽してくれることです。
しかし、初学者にとってはこの隠蔽が致命傷になるんですよ。
スピーカー 2
どういうことでしょう?
スピーカー 1
内部で何が起きているのか、メモリがどう変化しているのかという構造が見えないまま、表面的な英単語の羅列だけを覚えさせられるからです。
スピーカー 2
つまりそれって、現代の便利なオートマ車の運転だけを教わって、ボンネットの下にエンジンがあることすら知らないまま行動を走らされているようなものですね?
スピーカー 1
ああ、それはすごくわかりやすい例えですね。
順調に走っているときはいいけれど、一度エンスとして警告灯がついた瞬間、中で何が起きているのか全く想像できないから、完全にパニックになってしまうみたいな。
スピーカー 1
まさにその通りです。構造を知らないから、エラーが出てもどこを直せばいいかという仮説が立てられないんです。
MTL 3層アプローチと視覚化
スピーカー 1
そこで、ムセレの研究では、時代逆行ともいえる驚くべき解決策、MTL3ティアアプローチを提唱しています。
このアプローチを読んだときは、私も本当に驚きました。
スピーカー 1
あえて最初は、アセンブリ言語という機械語に限りなく近い、専門家でも敬遠するような低いレイヤーから教え始めるんですよね。
スピーカー 2
はい。しかし単に難しいコードを書かせるわけではないんです。
アセンブリ言語を通じて、コンピュータの物理的な動きを体感させるんですよ。
スピーカー 1
物理的な動きですか?
スピーカー 2
具体的には、最初はなんと、小石や容器を使った物理的なモデルを用いて、レジスタ、つまりCPU内の記憶領域ですね。
その間でデータがどう移動するかを実際に手で動かして学ばせるんです。
スピーカー 1
えー、小石を使うんですか?コンピュータの授業なのに。
スピーカー 2
ええ。日常の物理法則、つまりP-PRIMSに邪魔されるなら、逆にその物理的な動きを使って新しいメンタルモデルを上書きしてしまうという見事なアプローチなんです。
スピーカー 1
なるほど。抽象的な概念をまずは手に触れられる物理モデルに落とし込むわけですね。
スピーカー 2
その上で、今度は長方形だけの極めてシンプルな図解、MTLラムダダイアグラムを使って、メモリの状態を紙の上で視覚化します。
このステップを十分に踏んで、内部構造のメンタルモデルが完全に出来上がってから、ようやくPythonのような高水準言語を教えるんです。
スピーカー 1
図解というと、昔からあるフローチャートではダメだったんですか?七方とか平行四辺形を繋いでいくおなじみのやつです。
フローチャートはですね、認知負荷理論の観点から見ると、初学者には非常に負担が大きいんですよ。
スピーカー 1
人間のワーキングメモリー、つまり一度に処理できる情報の量には限界があります。
フローチャートは、菱形は条件分岐だ、平行四辺形は入出力だと記号の意味を覚えるだけで、脳のメモリを消費してしまいます。
しかも、それらの記号は実際のコンピューターのメモリ構造とは全く一致していません。
スピーカー 2
本質的なデータの流れを理解する前に、この記号なんだっけ?と思い出すことに脳のリソースを奪われてしまうわけですね。
スピーカー 1
一方、長方形だけのシンプルなMTLダイアグラムは、余計な記号を排除しているため、認知負荷を劇的に下げます。
学習者は、純粋にメモリの中でデータがどう変化しているかだけに集中できるんです。
スピーカー 2
それは理にかなっていますね。
スピーカー 1
結果として、このアプローチを受けた学生は、従来の学生に比べて正しいメンタルモデルを形成する確率が2.17倍高く、
よくあるエラーを回避する確率に至っては、なんと14.50倍も高かったという驚異的なデータが出ています。
スピーカー 2
14.50倍ですか。それはすごいですね。
表面的なわかりやすさを追求した言語が、いかに私たちの深い理解を妨げてきたかがよくわかる数字ですね。
あえてマニュアル車のエンジンの仕組みから学ぶことで、実は圧倒的に優秀なドライバーになれるんだということですね。
スピーカー 1
ええ、まさにそういうことです。
生成AI時代に必要なメンタルモデル
スピーカー 2
さて、低いレイヤーから構造を理解することの重要性がわかったところで、現代、つまりAI全盛の時代に視点を移しましょうか。
ここで少し意地悪な質問をさせてくださいね。
スピーカー 1
はい、なんでしょう。
スピーカー 2
今は2026年です。
スピーカー 1
汎用的な生成AIに、こういうアプリを作ってと指示すれば、完璧なコードが数秒で出力されますよね。
だったら、そもそもメンタルモデルなんて苦労して学ぶ必要はないんじゃないですか。
AIにうまく指示を出す方法、つまりプロンプトの出し方だけ学べばいいんじゃないかと思うんですが。
非常に鋭く、そして現代の教育現場が最も頭を悩ませている問いですね。
より大きな視点と結びつけると、結論から言って、AIがコードを書ける時代だからこそ、深いメンタルモデルがこれまで以上に重要になるんです。
スピーカー 1
そうなんですか。なぜでしょう。
認知科学者のリスターが提唱した、ネオ・ピアジェ的認知発達段階という理論を通して考えてみましょう。
スピーカー 1
認知発達段階。子供が成長するにつれて思考が複雑になっていくというあれですね。
スピーカー 2
プログラミング学習においても同じ発達段階があります。
初期の学習者は、目の前の具体的なコードの動きしか追えない具体的操作期にいます。
しかし、現実の複雑なシステムを設計するには、目に見えないデータ構造を推論する形式的操作期という高度な抽象的思考のステージに上がる必要があるんです。
なるほど。一段階上に行く必要があると。
スピーカー 2
ここでAIが正解のコードをすぐに与えてしまうとどうなるか。
学習者はいつまでたってもコードを表層的にコピペするだけで、自分で論理を組み立てる機会を奪われます。
結果として、思考が具体的操作期で止まってしまうんです。
そうなると、どういう問題が起きるんですか?
スピーカー 2
AIが出したコードが本当に正しいのか、想定外のバグが起きたとき、システムのどこに問題があるのかを検証する能力が育たないんです。
いわゆる学習性無力感に陥り、概念が未定着のまま、AIの単なるオペレーターになり下がってしまいます。
スピーカー 1
すぐに答えを教えてくれる過保護な家庭教師をつけてしまうと、テスト本番で自力で問題が解けなくなるのと同じですね。
じゃあ、教育においてAIは使わない方がいいんでしょうか?
StructDiag-AIと教師支援AI
スピーカー 2
そこで登場するのが、2026年の最新論文で発表されたStructDiag-AIのような、新しいパラダイムの教育支援AIなんです。
このAIは、答えを出すのではなく、学習者の思考のバグを診断することに特化しています。
スピーカー 1
思考のバグを診断する、どうやってやるんですか?
スピーカー 2
ここで、抽象構文木、ASTという技術が使われます。文章で例えるなら、単語のスペル間違いをチェックするのではなく、主語と述語の関係性、つまり文章の骨組みそのものを解析する技術です。
スピーカー 1
骨組みを解析する。
スピーカー 2
AIはこれを使って、セミコロンの抜けといった構文エラーではなく、ループの入れ子が論理的に破綻しているとか、この条件分岐には一生到達しないといった構造的なバグ、つまり学習者のメンタルモデルのズレを正確に
検知するんです。
スピーカー 1
なるほど。表面的なミスではなくて、根本的な勘違いを見抜くわけですね。
スピーカー 2
そして、最も重要なのは、このStructDiag-AIはソクラテス的に振る舞うという点です。正解のコードは絶対に教えません。
スピーカー 1
その代わり、この変数の値はループの2周目ではどうなっていると思う?といった段階的なヒントを与え、対話を通して学習者自身に気づきを促します。
スピーカー 2
へー、答えではなく思考を導く、まさに理想的なメンターですね。
スピーカー 1
データによると、このアプローチによりバグの解決率が38.4%向上し、長期的な概念の定着率が24.1%も向上したそうです。
スピーカー 2
素晴らしい数字ですね。さらに資料を読んで驚いたんですが、最近のAIは学生を指導するだけじゃなく、教える側の教員のスキルまで測定しているそうですね。
スピーカー 1
ああ、TPACKの評価に関する研究ですね。技術、教育、内容知識の習熟度を測るものです。これも非常に高度ですよ。
AIは学生がキーボードを叩くタイミング、バックスペースで消した履歴、コンパイルの頻度といった膨大なコードログを分析します。
スピーカー 2
つまりコンテナレベルのトレースですね。
スピーカー 1
はい。マルチ出力勾配ブースティングなどの高度な機械学習を用いて、教員がここで与えたヒントが本当に学生のメンタルモデルの構築に貢献したのかという因果関係まで可視化しているんです。
スピーカー 2
学生のタイピングの足跡から先生の教え方がうまかったかどうかまで丸裸にしてしまうとは、教育におけるAIの役割は完全に答えの提供器から認知プロセスの診断ツールへと進化しているんですね。
スピーカー 1
ええ、本当に劇的な進化です。
アンラーニングとプログラミング教育の意義
スピーカー 2
さて、これがリスナーのあなたにとって何を意味するのでしょうか。
スピーカー 1
ここまでプログラミング学習の深淵を除いてきましたが、これがプログラマーではないリスナーの皆さんにとって一体どんな意味を持つのでしょうか。
スピーカー 2
2020年度から順次全面実施されている日本の文部科学省の新しい学習指導要領を見るとその答えが明確に浮かび上がってきます。
国は全ての子供たちにプログラマーになってほしいわけではないんです。
というと、指導要領には社会の変化が激しく未来の予測が困難な時代において、変化を前向きに受け止め人間ならではの感性を働かせて社会を豊かにする資質能力を育むと明記されています。
学校の学びは社会と切り離されたものではないんです。
スピーカー 1
つまり、プログラミング学習の目的は単にコードを書くことではなく、見えないシステムの構造を理解し、自分の頭の中にあるメンタルモデルをアップデートし続ける訓練だということですね。
スピーカー 2
その通りです。AIが完璧なコードを書いてくれる時代だからこそ、人間は本当の課題は何か、どんな構造で解決すべきかという高いレイヤーでの概念設計に集中しなければなりません。
既存の思い込み、ピープリムズを疑い、抽象的な概念を論理的に組み立てるプロセスは、あらゆるビジネスや日常の意思決定における強力な武器になります。
スピーカー 1
なるほど。今回の深掘りで最も心に響いたのは、私たちが何か新しいことを学ぶとき、自分自身が無意識に持っている既存の知識やメンタルモデルが実は罠になり得るということなんです。
スピーカー 2
ええ、そこが最大の気づきですよね。
スピーカー 1
リスナーのあなたが今後、何を学ぶにしても同じです。壁にぶつかったときは、ぜひ自分の中にある既存のメンタルモデルが新しいシステムを歪めて解釈していないか、と疑ってみてください。
スピーカー 2
既存の知識を手放すアンラーニング、つまり学習棄却の重要性ですね。これは学ぶことよりも遥かに勇気とエネルギーがいる作業ですが、必要不可欠です。
スピーカー 1
まさに。そして最後に皆さんに一つ、少し挑発的な問いを投げかけて終わりたいと思います。
今日ご紹介したソクラテス的AIは、タイピングの履歴から私たちの論理の構造的バグを完璧に診断してくれました。
だとしたら、今後このようなAIがさらに進化すれば、プログラミングだけでなく、私たちの日常のビジネスの意思決定や人間関係、あるいは政治的スタンスにおける偏見や思考のバグまでも診断し、優しくアンラーニング
させてくれる日が来るのではないでしょうか。
私たちの個人的なバイアスを解きほぐしてくれる未来ですか。それは非常に刺激的であり、同時に人間の知性の自立性とは何かを根底から問う素晴らしい考えだと思います。
スピーカー 1
あなたの思考の根底にはどんな言語の罠が潜んでいると思いますか。ぜひご自身で探究してみてください。それでは今回の深掘りはここまでとさせていただきます。
21:25

コメント

スクロール