1. 高見知英のAI音声解析チャンネル
  2. テキストベースプログラム言語..
テキストベースプログラム言語の学習環境:ヘディ:子供のための段階的プログラミング言語(これからのプログラミング教育のかたち)
2026-10-22 21:10

テキストベースプログラム言語の学習環境:ヘディ:子供のための段階的プログラミング言語(これからのプログラミング教育のかたち)

これからのプログラミング教育のかたち

エグゼクティブ・サマリー

本ブリーフィング・ドキュメントは、初学者に対するプログラミング教育の現状課題と、それを克服するための革新的な指導法・システム設計に関する知見を整理・統合したものである。

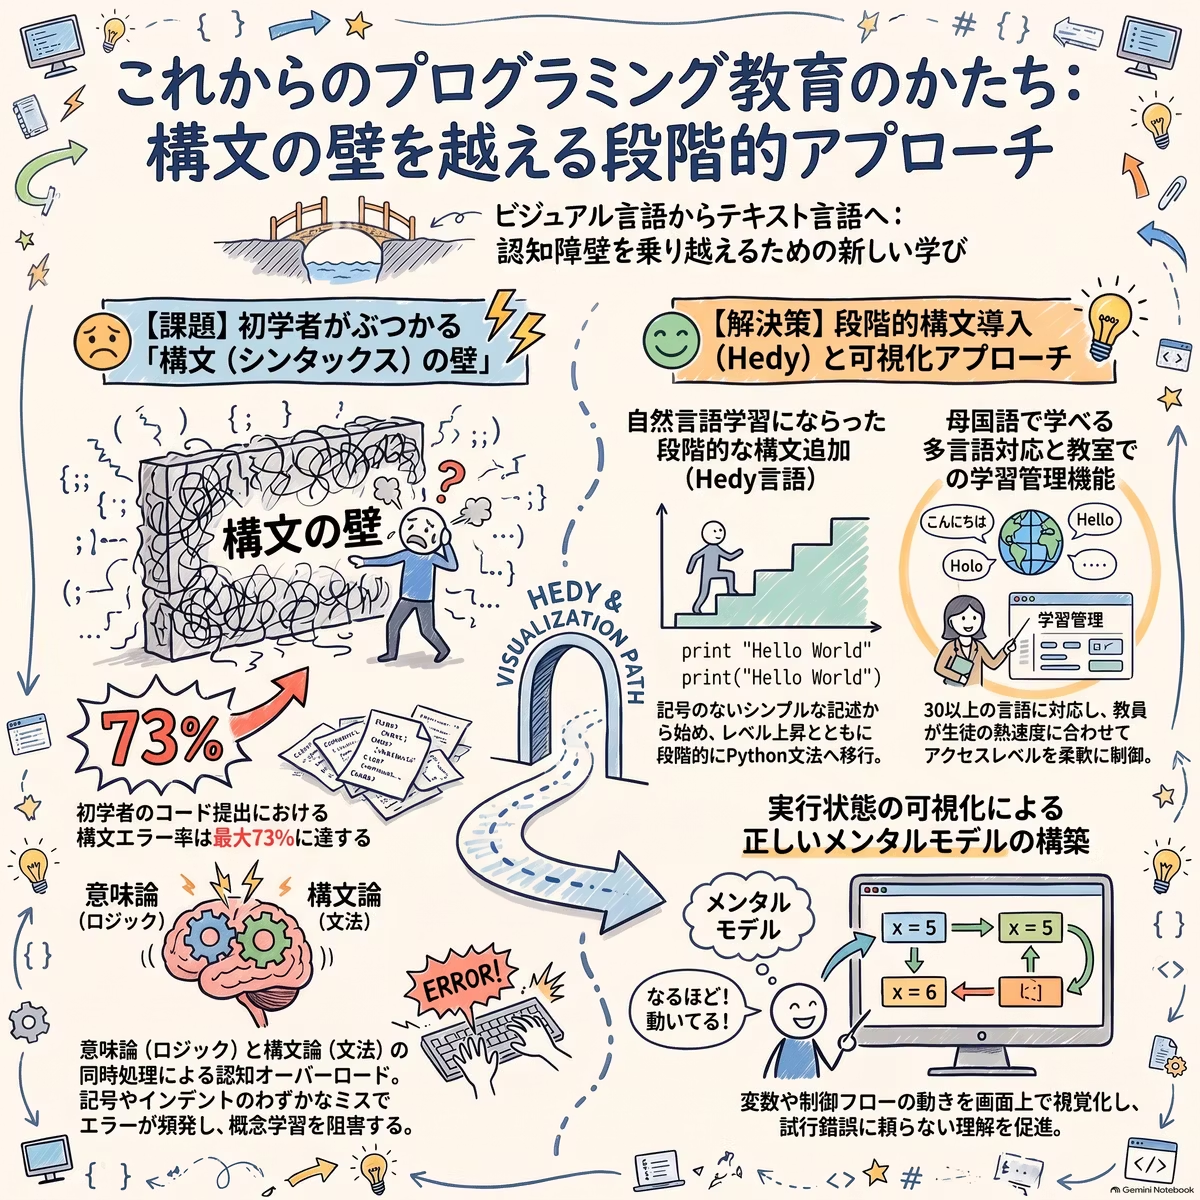
プログラミング教育における最大の障害は、初期段階で課される過度な「文法(シンタックス)の壁」とそれに伴う認知負荷(Cognitive Load)である。従来のエラーフィードバックやプログラミング言語(PythonやJava等)の硬直した構文ルールは、プロのエンジニア向けに設計されており、初学者の学習意欲と概念理解を著しく阻害してきた。研究データによると、プログラミング初学者の提出コードの50%〜73%にシンタックスエラーが含まれており、多くの学習者が論理的思考を深める前に構文の過誤によって挫折している。

この課題に対し、本ドキュメントでは以下の3つの主要なアプローチと解決策を提示する。

  1. ブロック型言語(Scratch等)からテキスト型言語への段階的移行: ライブコーディング、単語カードを用いた文法学習、試行錯誤(ティンカリング)といった教授法に加え、ブロックとテキスト(Python/JavaScript)をリアルタイムで相互変換・可視化するツール(Trinket.ioやMicrosoft MakeCode等)を活用した学習スキーム。
  2. 自然言語習得に着想を得た「漸進的(グラデュアル)プログラミング言語」(Hedy): 子供が自然言語の読み書きを学ぶ際、最初は小文字のみから始め、段階的に大文字、句読点、記号を追加していくプロセスをプログラミング言語に適用。Hedyは構文ルールを段階的(レベル1〜18)に変化させ、認知負荷を抑えながら最終的に標準的なPythonへと導く。また、31以上の言語ローカライズや右書き言語(アラビア語等)対応、教員による難易度コントロール機能を統合している。
  3. 視覚化・AI・学習分析を統合した環境(PyPLAS等): プログラム実行時の変数の状態変化や制御フローの「不可視性」を解消するため、実行状態の可視化ツール(Python Tutor等)を同一画面内に直接埋め込むアプローチ。さらに、直接的な解答を出さずに概念や戦略を提示する「段階的AIヒント(L1/L2/L3)」と、学習者の行動ログを「エンゲージメント」「推論戦略」「学習ペース」「ツール利用」の4次元で分析するプロセス認知型学習分析の導入。

これらの手法は、単にプログラミング文法を教えるだけでなく、学習者一人ひとりの能力に応じた個別最適な学び(差別化指導)を実現し、教員の指導負担を軽減しながら、コンピューショナル・シンキングの本質的な習得を可能にする新たなプログラミング教育の姿を示している。

1. 従来のテキスト型プログラミング教育における課題:「文法的障壁」と認知負荷

1.1 プログラミング教育における高い中退率とシンタックスエラーの統計

コンピューター・サイエンス(CS)教育において、初学者が直面する最大の難所は「正確な構文の記述」である。オランダの統計データでは、物理学専攻の学生の60%が6年以内に学位を取得するのに対し、CS専攻の学生の取得率は50%にとどまり、中退率(Attrition Rate)は約40%に達している。

先行研究によって明らかなとなった統計データは以下の通りである:

  • 高いエラー発生率:成績の低い学生の73%、上位の学生であっても50%のケースでシンタックスエラーを含むソースコードが提出されている(Denny et al.)。
  • 大規模コンパイル分析:250,000人の学生による3,700万回のコンパイルを分析した研究(Altadmri and Brown)によると、最も頻繁に発生したエラーは「括弧の不一致(mismatched brackets)」であり、約800,000回記録された。
  • 自然言語との距離:JavaやPerlなどの一般的な言語は、ランダムに生成されたキーワードを持つ人工言語と比較しても初学者にとって理解の容易さに大きな差がないという研究結果(Stefik and Siebert)があり、構文理解の難しさが際立っている。

1.2 コンパイラによるフィードバックの限界と認知負荷(Cognitive Load)

プログラミング言語のコンパイラやインタープリタは、プロの成人開発者にフィードバックを与えるよう設計されており、初学者に対する優れた指導者とは言えない。

  • 誤解を招くエラーメッセージ: 例えば、Pythonで末尾の閉じ括弧を忘れた際に出力される SyntaxError: unexpected EOF while parsing や SyntaxError: EOL while scanning string literal といったメッセージは、10歳前後の子供や初学者には理解不能であり、混乱と自己効力感の低下を引き起こす。
  • 「目に見えないエラー」と認知オーバーロード: Pythonにおけるインデントエラー(indentation error: unexpected indent)や、大文字の Print と小文字の print の違い、不要なスペースの混入などは、初学者にとって「コンピューターは計算が速くスマートなのに、なぜこの程度の違いを修正してくれないのか」という認知的な葛藤を生む。
  • 概念理解の阻害: 繰り返し(ループ)や変数といった「概念(Concepts)」を学ばせたい場面において、カンマ、クォーテーション、コロン、括弧などの「構文(Syntax)」に脳の認知資源が過度に費やされ、ワーキングメモリが飽和状態(認知オーバーロード)に陥る。結果として、プログラミングの本質的思考に集中できなくなる。

2. ブロック型からテキスト型へのスムーズな移行手法

2.1 ブロック型言語(Scratch)の長所と限界

初等教育では、Scratchなどのビジュアル(ブロック型)言語が広く普及している。

  • メリット:ドラッグ&ドロップで操作でき、構文エラーが発生しないため、初期段階で「コンピューターを制御できる」という自信を直感的に植え付けることができる。
  • 限界:中学生(11〜12歳以上)やキャリア意識を持つ生徒(特に都市部の学校など)からは「おもちゃの言語」と見なされがちである。また、複雑なデータ構造、大量のデータ処理、本格的なアルゴリズムの実装、実務的なWeb/ゲーム開発には適していないため、実用的なテキスト型言語(Python等)への移行ニーズが必然的に生じる。

2.2 移行を成功させる3つの教授法(Pedagogy)

ブロック型からテキスト型への移行を円滑に進めるため、以下の3つの教育的実践が有効とされる。

[ブロック型 coding (Scratch)] ──> 1. ライブコーディング (Live Coding)
                              ──> 2. シンタックス学習 (Syntax Learning) ──> [テキスト型 coding (Python/JS)]
                              ──> 3. ティンカリング (Tinkering)
  1. ライブコーディング(Live Coding): 教員が画面上で実際にコードを打ち込みながら、各行の意味を口頭で解説し、生徒が手元で同時に追体験する手法。ブロック型言語での対応する要素(例:Scratchの「くりかえす」ブロックとPythonの for ループ)と比較・関連付けながら進行する。
  2. シンタックス学習(Syntax Learning): 構文(シンタックス)を伝統的な教科の「語彙(ボキャブラリー)」と同様に扱う手法。単語カードの作成、用語と定義のマッチング、シンタックス・ビンゴ(Syntax Bingo)などを用いて、記号やキーワードを系統的に暗記・定着させる。
  3. ティンカリング(Tinkering): 基本的な知識を得た後、明確すぎる目標や失敗の重圧を持たせずに「コードをいじくり回して動作を確かめる」遊び感覚の実践。エラーや失敗を学習の機会として捉え直させる。

2.3 リアルタイム変換ツールと実践プロジェクト

移行のハードルを下げるため、ビジュアルブロックとテキストコードを相互変換・並行表示する環境が効果的である。

  • Trinket.io / Microsoft MakeCode: ブロックを配置すると、リアルタイムで同等のPythonやJavaScriptコード(Turtleグラフィックスの turtle.forward(30) や for ループ、begin_fill() など)が自動生成される。インデントやライブラリのインポート(import turtle)といった構造を視覚的に理解できる。
  • 初期移行プロジェクトの例:
    • 数当てゲーム(Guessing Game):random.randint()、while ループ、if-else 条件分岐を使用。Scratchで学んだ論理構造をテキストコードに置き換える代表例。
    • Turtleグラフィックスによる作図・アニメーション:スプライトを動かす感覚でテキストによる描画命令(線描、多角形、彩色)を学ぶ。
    • 簡易電卓(Simple Calculator):変数、関数の定義(def)、ユーザー入力の受け取りと算術演算を強化する。

3. 漸進的(グラデュアル)プログラミング言語「Hedy」のパラダイム

フリー大学アムステルダム/ライデン大学のフェリーネ・ヘルマンス(Felienne Hermans)教授によって開発された「Hedy(ヘディ)」は、自然言語の習得プロセスに着想を得た全く新しいプログラミング言語・学習プラットフォームである。

3.1 自然言語習得とシュナイダーマンの「螺旋的アプローチ」

子供が母語の書き言葉を学ぶ際、最初から大文字、小文字、ピリオド、カンマ、セミコロン、引用符を一度に教わるわけではない。最初はすべて小文字だけで文字を書くことから始まり、成長とともに段階的にルールを追加していく(ピアジェの発達段階説およびリスターのCS教育論に基づく)。

学習段階自然言語(書き言葉)の習得プロセスプログラミング言語(Hedy)の習得プロセス
初期すべて小文字のみで単語・文を書く(記号なし)括弧や引用符なしでコマンドとテキストを入力 (print Hello)
中期語のグループ化、簡単な文、大文字の開始変数の導入、引用符による型と変数の区別 ('Hello ' name)
後期文末のピリオド、カンマ、複雑な構文コロン、インデント、括弧、標準的なPython構文への移行

このアプローチは、1977年にベン・シュナイダーマン(Ben Shneiderman)が提唱した「螺旋的アプローチ(Spiral Approach)」(認知制限に合わせて少量の文法・意味論から始め、既存知識に最小限の要素を付け加えて段階的に拡張・変容させるアプローチ)を現代のプログラミング教育に直接実装したものである。

3.2 Hedyの6つの設計原則(Design Principles)

  1. 概念を形式を変えて少なくとも3回提示する:長期記憶への定着には反復が必要(単語の定着には7回の読了が必要とされる)。
  2. 初期の提示は可能な限り最も単純な形式にする:構文のキーワードや演算子を極力排除し、認知負荷を下げる。
  3. 一度に変更する要素は1つだけにする:変更幅を最小限にし、知識の転移(Transfer)を容易にする。
  4. 括弧やコロンなどの記号追加は可能な限り後回しにする:記号の音読難易度や発達段階を考慮し、まずはインデントなどを優先する。
  5. 新しい形式の学習は概念の合間に挿入(インターリーブ)する:分散学習(Spaced Repetition)の原則に基づき、構文変化の前に十分な練習時間を設ける。
  6. すべてのレベルで単純だが意味のあるプログラムが作成できる:モチベーション維持のため、初期レベルでもインタラクティブで魅力的な制作を可能にする。

3.3 レベル進行(Level Progression)の構造

Hedyはレベル1から始まり、最終的に標準的なPythonの機能的サブセット(レベル18)へとシームレスに到達する。

[Level 1] print Hello / ask / echo (記号なし)
   ↓
[Level 2] 代入に 'is' を使用 (name is Hank) / リスト機能
   ↓
[Level 3] 引用符 (' ') の導入 (文字列と変数の区別)
   ↓
[Level 4] フラットな条件分岐 (if name is Bert print 'Yellow')
   ↓
[Level 5] フラットな繰り返し (repeat 5 times print 'Hello')
   ↓
[Level 6] 計算演算子 (*, /) の導入
   ↓
[Level 7] コードブロックとインデント構造の導入
   ↓
[Level 8〜12] for文、コロン (:)、丸括弧 ( )、角括弧 [ ] の段階的追加
   ↓
[Level 13〜18] 'is' から '=' / '==' への置き換え、完全なPythonへ

3.4 多言語対応(Multilingual)と人間工学(Ergonomics)上の意義

Hedyは、エラーメッセージや画面UIだけでなく、プログラミングのキーワード(コマンド)そのものを31以上の言語にローカライズできる。オランダ語(ask → vraag)、スペイン語、フランス語、イタリア語、さらにはアラビア語などの右書き(RTL: Right-to-Left)言語にも完全対応している。

  • 人間工学上の課題解決: 英語を母語としない子供(例:アラビア語環境の子供)が英語キーワードでコードを書く場合、「キーボードの入力言語を英語に切り替えてコマンドを打ち、再びアラビア語に切り替えて文字列を打つ」という極めて煩雑な操作が必要となる。また、アルファベットの位置が分からない子供に対して教員が「p-r-i-n-t と打ちなさい」と指示しても学習が進まない。コマンドの自国語化はこの物理的・認知的手間を解消する。

3.5 教員支援と教室内の差別化指導(Differentiation)

Hedyは「学習(Learning)」だけでなく「指導(Teaching)」のために構築されている。

  • 認知コンテキストの統合(アドベンチャー機能): プログラミング画面の隣に教材(「オウム」「レストラン」「タートル描画」などのアドベンチャー課題)が直接埋め込まれており、生徒が紙のプリントや別タブとIDEの間で視線を往復させることによる認知負荷(コンテキストスイッチ)を抑える。タートル描画の成果物は刺繍ミシンやペンプロッターに出力可能であり、学びの成果を手に取れる形にできる。
  • UIのカスタマイズと能力差の管理: 教員画面から、クラス全体でアクセスできるレベルやアドベンチャーを制限・解放できる。進度の早い生徒が1,000行の高度なコードを書き、遅れている生徒が1行目で詰まっているような教室内の過度な分散を制御し、コホート(学習集団)の一体感を維持しながら個別指導を行うことができる。

3.6 実証評価とエラー分類データ

9,714のHedyプログラム(レベル1〜7)を対象とした実証評価では、全提出コードにおけるエラー発生率は**12.2%(1,363件)**にとどまり、従来のテキスト言語(50%〜73%)と比較して劇的に低い水準を示した。

エラー(1,363件)の分類内訳は以下の通りである:

エラーの分類カテゴリー件数割合 (%)具体的な原因・事例
不完全なコード (Incomplete code)25318.6%キーワードの引数忘れ、リストのカンマ欠落など
異なるレベルのコード実行 (Wrong level)25118.4%前のレベルの構文を上位レベルで使用(207件)、または未解禁構文の使用(46件)
キーワードの誤字・配置ミス (Misspelled/misplaced)23317.1%大文字入力、一文字抜け、自然言語に合わせた変更 (is の代わりに are)
無効な文字の使用 (Invalid character)21916.1%HTMLタグの混入、アクセント付き文字、意図しない記号
無効なスペースの使用 (Invalid spaces)17112.5%行頭の不要なスペース(インデントエラー原因)、引数間のスペース抜け
引用符に関する問題 (Quotes)1118.1%ダブルクォーテーションの使用、閉じ忘れ、文章内シングルクォートとの競合
複数行コマンドの誤用 (Multiline command)725.3%1行前提のレべルで if や else を改行して記述
Python構文の混入 (Python commands)261.9%以前にPython学習経験がある生徒によるカンマ区切り等の誤用
行番号の誤混入 (Line numbers)131.0%教材の例から行番号までコピー&ペーストしてしまうエラー
コードの入れ子エラー (Nested code)100.7%レベル6以下で複数の if を不適切にネストしようとするミス
コンピューター動作への誤解 (Misconception)40.3%自然言語を理解できると期待するミス、処理順序の誤解

4. AI・プロセストレーシング・視覚化を統合した学習支援システム(PyPLAS)

岡山大学などの研究チームが開発した「PyPLAS(Python Programming Learning Assistant System)」の高校生向け拡張インターフェースは、実行状態の可視化、イベントストリーム・ログ、段階的AIアシスタントを統合し、生徒の「盲目的な試行錯誤」を防止するシステムである。

4.1 実行状態の「不可視性」の解消(Python Tutorの埋め込み)

高校生などの初学者がPythonを学ぶ際、変数の遷移、分岐処理、ループ状態、関数呼出などの内部動作が見えないことが、無計画なコード修正の繰り返し(試行錯誤への依存)を引き起こす。

  • 低フリクションな視覚化: 視覚化ツール「Python Tutor」を演習画面内にiframeとして直接埋め込むことで、コードを別サイトへコピー&ペーストする認知的手間を排除。プログラムを実行しながら、メモリ内の変数変化やステップ実行をリアルタイムに確認・予測できる。

4.2 答えを直接教えない「段階的AIアシスト」(Non-Replacement Hint Policy)

ローカル大規模言語モデル(Ollama + Qwen2.5-Coder)を活用したAIアシスタントを搭載。AIが直接的な解答コード(ファイナル・アンサー)を提示してしまうと生徒の思考プロセスがスキップされるリスクがあるため、以下の3段階(L1/L2/L3)ヒントポリシーを強制している。

[生徒の質問/エラー] ──> L1: 概念的ヒント (Conceptual) ──> 概念の理解と問いかけ
                   ──> L2: 戦略的ヒント (Strategy)   ──> 処理手順の分解と順序のアドバイス
                   ──> L3: エラー特化ヒント (Error)   ──> 修正の方向性と最小限の手がかり
                   *(直接の解答コード出力は厳禁)*

短い間隔でL3ヒントが連続請求された場合は、依存ループを防ぐため、「ヒントを再請求する前に、期待される中間状態とプログラムの意図を再確認する」よう促す省察メッセージが出力される。

4.3 4次元のプロセス認知型学習分析モデル(Learning Analytics)

単に正解/不正解の「結果」だけを評価するのではなく、操作ログ(イベントストリーム)から生徒の「学習プロセス」を以下の4つの次元で定量化・診断する。

                       ┌── エンゲージメント (Engagement) : 時間投資とタスク完了率
                       ├── 推論戦略 (Reasoning Strategy) : 視覚化ツール vs 直接提出の比率
学習分析の4次元モデル ─┼── 学習ペース (Learning Pace)    : 操作間隔の安定性 (変動係数 CV)
                       └── ツール利用 (Tool Usage)       : ヒント請求頻度と試行回数の比率
  1. エンゲージメント(Engagement: E): 能動的学習時間と課題完了率の加重平均。 E = \alpha \cdot \frac{T_{\text{active}}}{T_{\text{target}}} + (1 - \alpha) \cdot \frac{N_{\text{complete}}}{N_{\text{assigned}}}
  2. 推論戦略(Reasoning Strategy: R_{\text{val}}): コード提出回数に対する視覚化ツールの起動回数の割合。数値が高いほど、提出前にステップ実行で確認する「能動的推論型」であり、低い場合は「無計画な試行錯誤型」と判定される。
  3. 学習ペース(Learning Pace: CV_{\text{val}}): 操作間隔の時間変動係数(標準偏差 \sigma / 平均 \mu)。数値の乱れが大きい場合、試行錯誤の迷いや混乱を示唆する。
  4. ツール利用(Tool Usage: U_{\text{ratio}}): 試行回数に対するAIヒント請求数の割合。ヒントへの依存度やヘルプシーキング行動を測定する。

教員によるプロファイル解釈と指導への応用

この4次元指標を組み合わせることで、教員は教室内の生徒タイプを以下のように判別し、適切な個別声かけを行うことができる:

  • 能動的推論タイプ:視覚化の活用率が高く(R_{\text{val}} 高)、ペースが安定(CV_{\text{val}} < 1.0)。
  • 試行錯誤依存タイプ:視覚化を使わず(R_{\text{val}} 低)、短い間隔で提出を繰り返す(CV_{\text{val}} > 1.2)。→ 視覚化ツールの使用を優先するよう指導。
  • サポート模索タイプ:ヒント請求と視覚化を双方適度に使用。
  • 低エンゲージメントタイプ:活動時間が極端に短くタスク未完了。→ 動機付けや操作上の躓きを確認。

4.4 パイロット適用結果(高校生20名による評価データ)

高校生20名を対象とした基礎Python課題(P1〜P6)のパイロット適用結果は以下の通りである。

課題解法結果(N=20)

課題ID学習トピック完了人数平均試行回数 (Attempts)平均ヒント請求数 (Hints)平均解法時間 (分)
P1出力と変数 (Output & Variables)201.40.12.5
P2算術演算 (Arithmetic)201.90.44.2
P3条件分岐 (if-else)202.51.27.1
P4forループ基礎 (For-loop)203.21.89.8
P5whileループ (While-loop)194.42.714.5
P6リスト反復 (List iteration)193.82.312.0

論理的複雑さが増すループ課題(P5、P6)においても、平均試行回数は4.5回以下に抑えられており、段階的ヒントと可視化機能が過度な試行錯誤を抑制したことを示している。

主観評価アンケート結果(5段階リカート尺度)

ID質問項目平均値 ± 標準偏差
Q1埋め込みPython Tutorは実行中の変数変化の理解に役立った4.45 ± 0.60
Q2L1/L2/L3の段階的ヒントは答えを直接与えず、思考を誘導してくれた4.15 ± 0.81
Q34次元の振り返りフィードバックは自らの学習習慣の理解に役立った3.80 ± 0.89
Q4システムのUIは直感的であり、他サイトへ移動せず使いやすかった4.30 ± 0.73
Q5全体として、本システムはエラー遭遇時の挫折感を軽減してくれた4.25 ± 0.71

4.5 学校現場のためのローカル構築アーキテクチャ(プライバシーとインフラ)

教育機関(特に小・中・高校)における通信帯域の制限や個人情報保護法・COPPA(児童オンラインプライバシー保護法)等の懸念に対応するため、PyPLASはクラウド依存を排除した**ローカルファースト・アーキテクチャ(Flask + Ollama + Docker)**を採用している。外部インターネットへ生徒の行動ログやコードを送信することなく、学校のローカルネットワークや教員用PC単体で完全に独立稼働させることが可能である。

5. 今後のプログラミング教育への示唆と提言

本ドキュメントで分析した知見に基づき、今後のプログラミング指導および教材開発に向けた主要な示唆を以下に整理する。

1. シンタックスとコンセプトの分離(認知負荷の最適化)

初学者に対するプログラミング指導では、「概念の理解(アルゴリズム思考)」と「構文の厳密さ」を切り離す設計が不可欠である。Hedyのように構文ルールを段階的に解放・変更していく手法や、文法要素を最小限に抑えた初期レベルの導入は、初学者の心理的ハードルを大きく下げ、プログラミング学習における中退率の改善に寄与する。

2. 人間工学と包摂的(インクルーシブ)デザインの重視

プログラミング言語を「英語圏の成人エンジニアの道具」としてのみ捉えるのではなく、母語で学べる環境(31言語ローカライズや右書き言語対応)や、キーボード操作の手間(言語切替)を減らすインターフェース設計が重要である。これにより、ジェンダーや言語的背景、家庭のPC環境の有無に関わらず、すべての子供にプログラミングへのアクセスを保証できる。

3. 「答えを出さないAI」による思考の足場かけ(Scaffolding)

生成AIを教育に導入する際、単に動作するコードを出力させるツールとして与えると、生徒の論理的思考力や自己デバッグ能力の育成が阻害される。L1/L2/L3のように、概念的問いかけ→解法戦略の分解→エラー箇所の示唆というように「段階的に思考を支援するプロンプト設計・システム制約」を組み込むことが求められる。

4. 結果評価からプロセス分析(Learning Analytics)へのシフト

プログラミング課題の評価を「正解か不正解か」の二元論から、生徒の試行間隔、視覚化ツールの利用履歴、AIヒントの頼り方といった「行動ログのプロセス分析」へと移行させるべきである。教員はシステムから得られる学習分析プロファイルを活用することで、手助けが必要な生徒(無計画な試行錯誤を繰り返す生徒や低エンゲージメントな生徒)を早期に発見し、効果的な介入を行うことができる。

感想

まだ感想はありません。最初の1件を書きましょう!

サマリー

初心者がプログラミングで挫折する主因として、論理そのものよりも厳密な構文とコンパイラの分かりにくいエラーが取り上げられます。ScratchからPythonなどのテキスト言語へ移る際には、ライブコーディング、構文学習、ティンカリング、ブロックとテキストの相互変換が有効だと説明されます。自然言語の習得に着想を得たHedyは、簡単な構文から始めて段階的にPythonへ近づけ、多言語や右書き言語にも対応します。さらに、Python Tutorなどの可視化ツールやWebAssemblyによるブラウザ完結型環境が、プログラム内部の動きと環境構築の問題を支援します。AI教育では、解答を直接示さず行動ログに応じて段階的なヒントを出す一方、子どものデータ保護と個別最適化の両立が課題になります。

構文の壁と初心者の挫折
スピーカー 1
あの,突然なんですけど,あなたも何か新しいスキル,例えばプログラミングなんかを学ぼうとして,どうしてもわからなくて挫折しちゃった経験ありませんか?
スピーカー 2
ああ,それ結構多くの方が経験していることですよね。
スピーカー 1
そうなんですよ。誰かに教えようとして悪戦苦闘したなんて人もいるかもしれませんけど。で,実は今回,新しくプログラミングを学ぼうとした初心者の実に73%が挫折しているっていうデータを見つけまして。
スピーカー 2
73%ですか?それはまたすごい数字ですね。
スピーカー 1
そうなんですよ。しかもこれ論理的な思考が苦手だからとかそういう理由じゃないらしいんですよね。
スピーカー 2
ええ。実はコンピューターが信じられないくらい融通の効かない,まあ言ってしまえば最悪の教師だからというのが一番の理由なんですよ。
スピーカー 1
最悪の教師ですか?
ええ。しかも驚くべきことに他の分野で優秀な成績を収めているような学習者であっても半数が全く同じ理由で壁にぶつかっているというデータもあるんです。
スピーカー 1
ええ,優秀な人でも半分はつまずくって相当な壁じゃないですか。ということで今回の深掘りテーマはずばりこれからのプログラミング教育の形です。
スピーカー 2
はい,非常に重要なテーマですね。
スピーカー 1
今日は最新の教育工学の学術論文から開発者向けカンファレンスであるストレンジループ2022の講演録,あとはコーディンガルやBSDエデュケーションといった教育プラットフォームの専門記事,さらには最新の教
育システムアーキテクチャのレポートまで分厚い資料の束をがっつり読み込んできました。
スピーカー 2
かなりの情報量でしたね,今回は。
スピーカー 1
そうなんですよ,今回の私たちのミッションなんですけど,Scratchみたいなブロックを組み合わせる直感的なおもちゃのようなツールからPythonのようなプロフェッショナルなテキストベースの言語へ移行する際
ですね,その時にどうすれば学習者の心を折らずに導けるのか,その驚くべき最新アプローチとテクノロジーの進化を解き明かすことです。よし,ここから紐解いていきましょうか。
Scratchからテキスト言語への移行
スピーカー 2
よろしくお願いします。現在のプログラミング教育の入り口としてScratchのようなブロックベースの言語って本当に非常に優れているんですよね。
スピーカー 1
そうですよね,あの猫のキャラクターを動かしたりするやつですよね。
スピーカー 2
そうそう,それです。視覚的で直感的ですし,何よりタイピングのミスが起きないんですよ,ブロックをはめ込むだけですから。
スピーカー 1
確かに,スペルミスとかは絶対に起きない仕様になってますよね。
スピーカー 2
ええ,でも学習者が成長して,もっとお金が稼げるような本格的なテキスト言語を書きたい,Pythonをやりたいって言い出した瞬間に,巨大な罠が待っているんです。
スピーカー 1
ああ,それがさっきの初心者の73%が挫折するっていうデータにつながるわけですね。
スピーカー 2
その通りです。資料にあった3700万回ものコンパイル履歴を分析した研究結果がそれを証明しています。
スピーカー 1
3700万回ってとんでもないデータ量ですね。
初心者がPythonなどのテキスト言語の世界に入った途端,公文エラー,いわゆるシンタックスエラーという壁に激突して,粉々に打ち砕かれているんですよね。
スピーカー 2
シンタックスエラー出ますよね,あれ本当に意味不明で。
スピーカー 1
コンパイラって,つまり人間が書いたコードをコンピューターが実行できる形式に変換するプログラムのことなんですが,
もともと大人のプロフェッショナルエンジニア向けに設計されているんですよ。
スピーカー 2
なるほど,プロ向けだから容赦ないんですね。
スピーカー 1
そうなんです。だから10歳の子供が画面に文字を出そうとして,括弧をたった一つ忘れたり,行の頭のスペースが一つ多かったりしただけで,もう容赦なくエラーを出します。
スピーカー 2
なんかシンタックスエラー,アンエクスペクテッドEOFみたいな。
スピーカー 1
そうそう,初心者には暗号にしか見えないエラーメッセージを冷酷に突きつけてくるんです。大人のプロでもイラっとするようなメッセージですからね。
スピーカー 2
コンピューターってものすごい計算能力を持っているんだから,ここは括弧を書き忘れたんだな,くらい気を利かせて実行してくれてもいいじゃないですか。
スピーカー 1
本当,そう思っちゃいますよね。でもしてくれないんです。
これって例えるなら,補助輪付きの自転車に乗っていた子供をいきなり高速道路のど真ん中に放り込むようなものですよね。
スピーカー 1
確かに.
スピーカー 2
あとは,レストランでピザを注文するときに,ピザをお願いしますって完璧な文法で言えば通るのに,ピザをお願いしますってちょっと変なところに苦闘点を入れただけで,
シェフが激怒して注文書を破り捨てて店から叩き出されるみたいな.
スピーカー 1
そうそう,それくらい理不尽ですよね。
スピーカー 2
それはコンパイラの無慈悲さを完璧に表しているすごくいい例ですね。
これ,リスナーのあなたも,普段仕事で新しいソフトウェアを使っているときに,ほんの少しの入力ルールの違いで原因不明のエラーが出て,もう作業を全て投げ出したくなった経験あるんじゃないでしょうか?
スピーカー 1
あります,あります。もうパソコンの電源切りたくなりますもん。
初心者が最初に感じる強烈な挫折の正体って,実はプログラミングの概念自体が難しいからではないんです。
スピーカー 1
違うんですか?
スピーカー 2
はい,この厳密すぎる構文,つまりシンタックスに気を取られて,脳の処理能力,いわゆるワーキングメモリーが完全にパンクしてしまうことに原因があるんですよ。
スピーカー 1
なるほど,括弧の場所とかスペースの数に気を取られすぎて,本来やりたかったどういうゲームを作るかという思考にたどり着く前に疲れ果てちゃうわけですね。
スピーカー 2
まさにその通りです。
Hedyの段階的プログラミング
スピーカー 1
じゃあその理不尽なレストランのルールをどうやって変えればいいのかって話になるんですけど,今回読んだ資料の中で私が一番興奮したのが,HEDIというプログラミング言語のアプローチなんです。
スピーカー 2
ああ,HEDIですね。これはオランダのライデン大学のフェリアン・ヘルマンス教授が開発した非常に画期的な言語です。
スピーカー 1
これ本当にすごいアイディアですよね。ここで非常に興味深いのは,ヘルマンス教授が人間の母国語,つまり自然言語の習得プロセスをそのままプログラミング教育に直接持ち込んだという点なんです。
自然言語の習得プロセスっていうと,私たちが小さい頃にどうやって日本語とか言葉を覚えたかみたいなやり方ですか?
スピーカー 1
そうです。例えば,5歳の子供が字を書き始めた時のことを想像してみてください。
スピーカー 2
はい,ひらがなを練習している時とかですね。
スピーカー 1
ええ,彼らが文字を書き間違えたり,英語圏ならピリオドを忘れたからといって,はい,シンタックセーラー,やり直し,って怒鳴る大人はいないでしょう。
スピーカー 2
絶対いないですね。そんなことしたら子供が泣いちゃいますよ。
スピーカー 1
そうですよね。まずは単語が書けたこと自体を褒めて,次に単語と単語の間のスペースを教え,そして最後に文末のピリオドや大文字といった複雑なルールを徐々に教えていきますよね。
スピーカー 2
確かにいきなり完璧な文法なんて絶対に求めませんね。
ヘディはまさにそれをプログラミングのコードでやっているんです。
スピーカー 2
プログラミングで段階的に教えるって具体的にはどうやるんですか?
スピーカー 1
ヘディには学習者のレベルに合わせて最大18の段階,レベルによっては13の段階が用意されています。
スピーカー 2
18段階もあるんですか?
スピーカー 1
はい。レベル1では引用符も括弧も一切使いません。ただプリント括弧ハロと書くだけで画面に文字が出ます。
スピーカー 2
え?括弧なしで動いちゃうんですか?
スピーカー 1
動くんです。まずはそこでコンピューターに命令すると出力されるという最も基本的な概念だけを学びます。
そしてレベルが上がるごとに変数が導入され,引用符のルールが追加され,括弧が追加されと徐々にルールが厳格化していくんです。
スピーカー 2
なるほど。
スピーカー 1
そして最終レベルに到達する頃には,完全な正しいPythonのコードへと自然に移行しているという仕組みなんです。
スピーカー 2
ちょっと待ってください。それって最初にわざと簡略化された,今は間違った文法を教えてしまうってことですよね?
スピーカー 1
まあ厳密なPythonのルールからすればそうです。
スピーカー 2
それって後になって,実はあの書き方は間違いで,本当は括弧が必要なんだよってルールを変えた時に,かえって学習者の頭を混乱させませんか?
一度覚えた癖を直すのってかなり大変だと思うんですけど。
いや,そこが人間の認知の素晴らしいところなんですよ。
スピーカー 2
と言いますと?
スピーカー 1
私たちの脳はメンタルモデルを後から柔軟にアップデートできる構造になっているんです。算数の教育を例に出しましょうか。
スピーカー 2
算数ですか?
スピーカー 1
ええ。小学校の低学年では,小さい数から大きい数は引けないって教わりますよね。リンゴ3個から5個は取れませんと。
スピーカー 2
はいはい,教わりました。マイナスなんて知らないですからね。
スピーカー 1
でも中学生になれば,マイナスの数という新しい概念を教わり,古いルールはあっさりと上書きされます。
それでも子供たちは,え?リンゴの話と違う!なんて永遠に混乱したりはしませんよね。
スピーカー 2
ああなるほど,あの時はああ教わったけど,もっと広い世界に行ったら新しいルールがあったんだって自然に受け入れているわけですね。
スピーカー 1
そういうことです。学習者のメンタルモデルは段階的に更新されていくものであり,プログラミングでもそれで全く問題ないんです。
スピーカー 2
すごく腑に落ちました。
スピーカー 1
さらに,ヘディのもう一つの革新的な点は,31以上の多言語に対応していることです。
オランダ語やスペイン語はもちろん,アラビア語のような右から左へ読む言語にまで対応しているんですよ。
スピーカー 2
ああ,資料にありましたね。
アラビア語圏の子供たちが従来のPythonを学ぼうとすると,コマンドを打つためにキーボードをいちいち英語に切り替えて,またテキストを打つためにアラビア語に切り替えてっていう物理的な手間が毎回発生するって。
スピーカー 1
そうなんです。ただでさえ公文を覚えるのに必死な初心者に,キーボードのショートカットで言語を切り替え続けるという,エルゴノミクス,つまり人間工学的な負荷まで敷いていたんですよ。
スピーカー 2
それはきついですね。考えただけで嫌になります。
ホディはこれを解消して,母国語のままで,純粋にプログラミングのロジックそのものに集中できるようにしたんです。
スピーカー 2
言語の切り替えっていう余計な認知負荷まで完全に削ぎ落としたわけですね。
スピーカー 1
ええ。さて,ヘディのおかげで公文エラーで心が折れるという最大の問題は解決したとしましょう。
でも,ここで私が子供だったらきっとこう思うんですよ。
ほう,何でしょう?
ブロックとテキストをつなぐ環境
スピーカー 1
昨日までScratchでカラフルな猫を走らせてビームとか打たせて面白かったのに,
今日からは黒子無機質な画面に文字を出すだけなの?って退屈すぎて死にそうって思いませんかね?
まさにそこがテキスト言語への移行におけるもう一つの巨大な壁なんです。
パラダイムの断絶と呼ばれる問題ですね。
スピーカー 2
パラダイムの断絶?
スピーカー 1
Scratchはスプライトと呼ばれるキャラクターを画面に配置して
クリックされた時といったイベントをきっかけにアニメーションを作る非常に視覚的で自称駆動型のパラダイムを持っています。
スピーカー 2
はい,ゲーム作ってる感がすごいですもんね。
一方でPythonの初期学習はコンソール画面でのテキストの入出力という全く異なるパラダイムから始まってしまうんです。
スピーカー 2
このギャップって大きすぎますよね。
でもこのギャップを埋めるためにノートにあったピッチという環境がすごく賢いアプローチをしていましたよね。
スピーカー 1
ピッチのアプローチは非常に興味深いです。
スピーカー 2
Scratchのスプライトとかイベントっていう概念をそのまま残して中身のコードだけをPythonで書かせるんですよね。
いわばScratchのレンズを通してPythonを見るみたいな感じでした。
スピーカー 1
その通りです。
またメイクコードやトリンケットといった環境ではブロックの表現とテキストの表現、例えばPythonやJavaScriptですね。
これを画面の左右に並べてリアルタイムで相互変換するデュアルモード機能というのを提供しています。
スピーカー 2
左がブロックで右がテキストみたいな。
スピーカー 1
はい。画面上でブロックをドラッグして動かすと隣の画面にあるPythonのコードもそれに合わせて同時に書き換わるんです。
スピーカー 2
これ洋画を見るときの字幕の仕組みにすごく似てますよね。
字幕ですか?
スピーカー 1
最初は日本語の字幕、つまりブロックの方を見ながら英語の音声を聞いているうちに、
このブロックの塊はPythonだとこの3行のテキストになるんだなって頭の中で勝手に構造を一致させていくようになるじゃないですか。
スピーカー 2
それは完璧なアナロジーですね。
未知のテキストコードと馴染みのある視覚ブロックの間を学習者自身が心理的安全性をもって行き来しながら対応関係を発見していく。
これは脳が新しい概念をマッピングするプロセスをシステム側が強力に支援している状態だといえます。
可視化とブラウザ型学習環境
いやー、よくできてますね。
スピーカー 1
ここからが本当に面白いところなんですが、エラーも出なくなった。退屈もしなくなった。
じゃあ、いざコードを書いて実行したときに、今度はコンピュータの内部で一体何が起きているのか全く見えないという新たな問題にぶつかりますよね。
スピーカー 2
そうなんです。プログラムを実行した際、変数の値がどう書き換わっているのかとか、ループ処理がどういう順番で回っているのかといったプロセスはメモリ上で一瞬にして処理されてしまいます。
スピーカー 1
ボタンを押したら結果が出るだけみたいな。
スピーカー 2
ええ、人間には最終的な結果しか見えません。
実は初心者がつまずく最大の要因の一つは、この見えない内部の動きに対するメンタルモデルが構築できていないことなんです。
スピーカー 1
そこで、PythonチューターやTony IDEのような可視化ツールが出てくるわけですね。
スピーカー 2
その通りです。
スピーカー 1
コードが一行実行されるごとに、メモリの中身がどう変わったかをまるでスローモーションのビデオを再生するように、一ステップずつ図解してくれるんです。
スピーカー 2
それがあれば、自分が書いたコードのどこで予想と違う動きをしたのかが一目でわかりますね。
スピーカー 1
はい。ただ、こうした高度な可視化ツールを実際の教育現場に導入しようとすると、今度は環境構築の悪夢が待っているんです。
スピーカー 2
環境構築の悪夢ですか。なんか怖そうな響きですね。
スピーカー 1
現在、多くの学校でBYOD、つまり生徒が自分の端末を持ち込むスタイルが導入されています。
そのため、生徒たちが持ち込む端末はWindows、Mac、Chromebook、iPadとOSが完全にバラバラなんですよ。
スピーカー 2
ああ、なるほど。
そこに、Pythonの実行環境やら、パスを通す設定やら、さらには可視化ソフトウェアまで個別にインストールさせようとしたら、それだけで数回の授業が終わってしまいます。
スピーカー 2
いや、めちゃくちゃわかります。私も経験ありますよ。
環境構築の途中で、謎のパーミッションエラーとか出て、結局その日は何も学べずに終わったこと。
スピーカー 1
あるあるですよね。
スピーカー 2
資料にあるWebTigerPythonのようなブラウザ完結型のWebIDEは、その問題をどう解決しているんですか?
WebAssemblyという技術が鍵になっているようですが、これって専門外界にはどういう意味を持つんでしょうか?
簡単に説明しましょうか。通常、ブラウザというのは、ウェブサイトを見るための単なる窓枠にすぎません。
スピーカー 2
はい。検索したり動画見たりするだけの窓ですね。
しかし、WebAssemblyという技術は、ブラウザに魔法をかけて、それ単体で超高速に動く独立したコンピューターに変えてしまうようなものなんです。
スピーカー 1
ブラウザ自体がコンピューターになっちゃうんですか?
スピーカー 2
ええ。つまり、複雑なPythonの実行環境や高度な可視化ツール、さらにはロボット制御のライブラリーまでもが、手元のパソコンに何もインストールすることなく、ただブラウザを開くだけで、そのままローカル環境
のようにサクサク動くようになったんです。
なるほど。じゃあ生徒は、ただ特定のURLにアクセスするだけで、自分のパソコンのOSが何であろうと、一瞬で完璧なプログラミング環境と可視化ツールが手に入るわけですか?
スピーカー 2
そういうことです。技術的なインフラの進化が、教育のアクセシビリティ向上に直結しているわけですね。
スピーカー 1
それは革命的ですね。
AIヒントと学習データのガバナンス
スピーカー 2
そして、教育環境の進化といえば、最新の教育システムにおけるAIの介入についても触れておく必要があります。
スピーカー 1
ああ、AIですね。避けては通れない話題です。
スピーカー 2
資料で紹介されているPyPlusというシステムでは、AIアシスタントが学習者のサポートに入ります。
スピーカー 1
AIのサポートって聞くと、ChatGPTみたいに、このゲームを作るためのコードを全部書いてってお願いして、一発で答えを出してもらうのを想像しちゃうんですが、そうではないんですよね。
スピーカー 2
はい。そこが非常に重要な設計思想になっています。
AIにいきなり答えのコードを出力させてしまうと、学習者は思考を放棄して過度にAIに依存してしまいますから。
コピペするだけになっちゃいますもんね。
スピーカー 2
ええ。
スピーカー 1
PyPlusでは、AIは直接答えを出しません。その代わり、裏側で学習者の行動ログをじっくり分析しているんです。
スピーカー 2
行動ログですか?
スピーカー 1
例えば、コードを書き換えるペースが極端に落ちていないかとか、同じエラーを何度も繰り返していないかといったエンゲージメントのデータですね。
スピーカー 2
ふむふむ。
スピーカー 1
そして、この生徒は行き詰まっているなと判断した場合にのみ、L1、L2、L3といった段階的なヒントを出します。
スピーカー 2
なるほど。まずは、この変数の意味を確認してみて、みたいな概念的なヒントから始めて。
スピーカー 1
そうですね。それでもダメなら、もう少し具体的なアドバイスにしていく。あくまで学習者自身に考えさせるように導くわけです。
スピーカー 2
理想的な先生ですね。
スピーカー 1
ええ。ただ、これをさらに大きな視点と結びつけてみると、ここには開発者たちを悩ませる非常に厄介なテクノロジーのジレンマが隠されているんです。
スピーカー 2
ジレンマですか?
スピーカー 1
はい。適切なタイミングでその子にぴったり合ったヒントを出すためには、AIはその子が今画面のどこを何分間見つめて、どのキーを叩いて消したかという詳細な行動ログをリアルタイムで把握する必要がありますよね。
スピーカー 2
まあ、そうですよね。状況がわからなければアドバイスできませんから。
スピーカー 1
しかし米国には、13歳未満の子供のオンラインデータを厳格に保護するCOPPA、児童オンラインプライバシー保護法や教育記録を保護するFARPAといった厳密な法規制が存在するんです。
スピーカー 2
あ、なるほど。
スピーカー 1
10歳の子供のタイピング履歴とか思考の癖といった極めてパーソナルなプロファイリングデータをAIのサーバーに送り続けるのは法律的にアウトになる可能性があるわけですね。
スピーカー 2
そうなんです。個別最適化された素晴らしいAI教育を提供したい一方で、生徒の詳細なデータをむやみに収集・保存してはいけないというルールに縛られているんです。
スピーカー 1
それはいたしかゆしですね。
スピーカー 2
ええ。そのため開発者は、個人を特定せずにリアルタイムのセッション内だけで分析を完結させるなど、非常に高度で困難なアーキテクチャの構築を迫られています。
スピーカー 1
これって実はリスナーの皆さんが職場で直面している問題と全く同じですよね。
スピーカー 2
どう言いますと?
スピーカー 1
便利なAIツールを導入して業務を効率化したいけれど、社内の機密データや顧客情報をAIに読み込ませていいのかというコンプライアンスの壁です。
データを使えばシステムは賢くなるけれど、データは守らなければならないという普遍的な利便性対ガバナンスのトレードオフですね。
スピーカー 2
まさにその通りです。テクノロジーが進化し、AIがパーソナライズされた支援を行うようになるほど、私たちはどのようなデータを誰の管理下でどこまで利用してよいのかという境界線を慎重に引いていかなければなら
ないんです。
人間中心のプログラミング教育
スピーカー 1
なるほど。さてここまで様々な資料を深掘りしてきましたが、これら全ては一体何を意味しているのでしょうか。
スピーカー 2
総括ですね。
スピーカー 1
コンパイラの都合に人間を合わせるのではなく、自然言語のように徐々にルールを学ぶヘディ、字幕のようにブロックとテキストの世界をつなぐデュアルモード機能、そして見えない内部の動きを可視化するツールに答えを
与えすぎずにデータを元に伴奏するAI。
これら全てに通定しているのは、いかに学習者の認知的な負荷を下げ、心理的な安全性を保ちながら成長させるか、という究極のユーザーエンパシーの形だと言いますね。
スピーカー 2
本当にそうですね。システムの都合に人間を合わせるのではなく、人間の認知の仕組みや心理的なハードルに合わせてテクノロジーやシステムの側を柔軟に変容させていく。それがこれからの教育工学のメインストリーム
になっていくのは間違いないでしょう。
スピーカー 1
最後に、今日の資料を踏まえた上で、リスナーのあなたに一つ新たな視点をお渡しして締めくくりたいと思います。
今日、私たちはシンタックス、つまり構文の壁をいかに低くして子どもたちにPythonなどのテキスト言語を教えるかを見てきましたよね。
スピーカー 2
そうですね。
スピーカー 1
しかし、プログラミング教育がこれほどまでに人間の自然言語や認知プロセスに寄り添うように進化しているのだとしたら、遠くない未来、私たちがAIに向かって自然言語で対話するだけで複雑なシステムが自動で構築さ
れるようになるはずです。
スピーカー 2
なるほど。究極の自然言語プログラミングですね。
スピーカー 1
そうなれば、そもそも構文そのものを学ぶ必要すらなくなる日が来るかもしれません。
その時、プログラミング教育が子どもたちにあるいは私たち自身に本当に教えるべき究極のスキルとは一体何になるのでしょうか。
スピーカー 1
ぜひあなた自身で考えてみてください。
テクノロジーが変われば学ぶべき本質も変わる。非常に深く考えさせられる問いですね。
今日の深掘りにお付き合いいただきありがとうございました。
あなたが次に新しいツールを学んだり、誰かに何かを教えたりする際のヒントになれば嬉しいです。
それではまた。
21:10

コメント

スクロール