1. 高見知英のAI音声解析チャンネル
  2. 2026年のインターネット情報収..
2026年のインターネット情報収集術:AIハルシネーション対策と情報評価力の育成
2026-10-29 20:30

2026年のインターネット情報収集術:AIハルシネーション対策と情報評価力の育成

基本データ

人工知能技術が教育や研究の現場に広く浸透するにつれて、もっとも深刻な課題となっているのがAIハルシネーション(情報の捏造や誤り)です。これらのソースは、もっともらしい嘘を出力する生成AIの特性をふまえ、学習者や専門家が陥る認知の脆弱性や過度な依存のリスクについて詳細に論じています。こうしたリスクに対処するため、文献では多読法(ラテラルリーディング)やSIFTメソッドといった実践的な検証技術を習得し、情報の真偽を見極める能力を養う重要性が強調されています。さらに、単なる受動的な利用から脱却し、Socraticな対話や批判的思考を駆使して主体的に情報を監査する姿勢が求められています。総じて、AI時代の情報環境において正確な知識を守り抜くためには、個人の情報リテラシーやデジタル市民としての責任感を体系的に高めていく必要があると結論づけられています。

AI生成コンテンツにおける「ハルシネーション」の解明と2026年における情報検証・リサーチ手法の体系的パラダイム:ブリーフィング・ドキュメント

エグゼクティブ・サマリー

本ブリーフィング・ドキュメントは、教育機関および高度リサーチ環境における人工知能(AI)の急速な普及に伴い浮上した2つの中心的課題、すなわちAI生成コンテンツにおける「ハルシネーション(錯覚・虚飾)」の発生メカニズムと教育的克服策、ならびに2026年現在におけるAI駆動型情報収集エコシステムの体系的構造と実践的検証パラダイムについて、包括的かつ緻密に合成・分析したものである。

主要な発見および結論は以下の通りである:

  1. 用語と技術的本質の再定義(「ハルシネーション」から「虚飾:Confabulation」へ)
    AIが自信満々に生成する事実無根・不正確な情報(ハルシネーション)は、意識的知覚エラーではなく、確率的言語モデル(LLM)のトークン予測アルゴリズムと訓練データの不完全性に起因する「虚飾(Confabulation)」と捉えるのが技術的に正確である。これを提示・理解させることで、AIを「万能の神託」ではなく「不完全な確率的ツール」と看破する批判的視点が養われる。
  2. 教育・学習への影響と基礎リクリテラシーの再構築
    AIへの過度な依存は「認知のオフローディング(Cognitive Offloading)」を引き起こし、批判的思考力を衰退させるリスクがある。これに対抗するため、クリティカル・シンキング、情報リテラシー(アルゴリズム・リテラシーへの進化)、デジタル・シチズンシップを三位一体の基礎として位置付ける必要がある。
  3. 検証技術の実践指導とソクラテス的対話の有効性
    従来の1つのWebサイトを深く読む「垂直的読解」から、複数タブで外部ソースを検証する「横断的読解(Lateral Reading)」および「SIFTメソッド(Stop, Investigate, Find, Trace)」への移行が不可欠である。また、AIの出力を鵜呑みにせず根拠や前提を問いただすソクラテス的指導法(Socratic Pedagogy)や事前予防的な「プレバンキング(Prebunking)」が極めて高い効果を示す。
  4. 2026年におけるAIリサーチ・エコシステムの3層アーキテクチャ
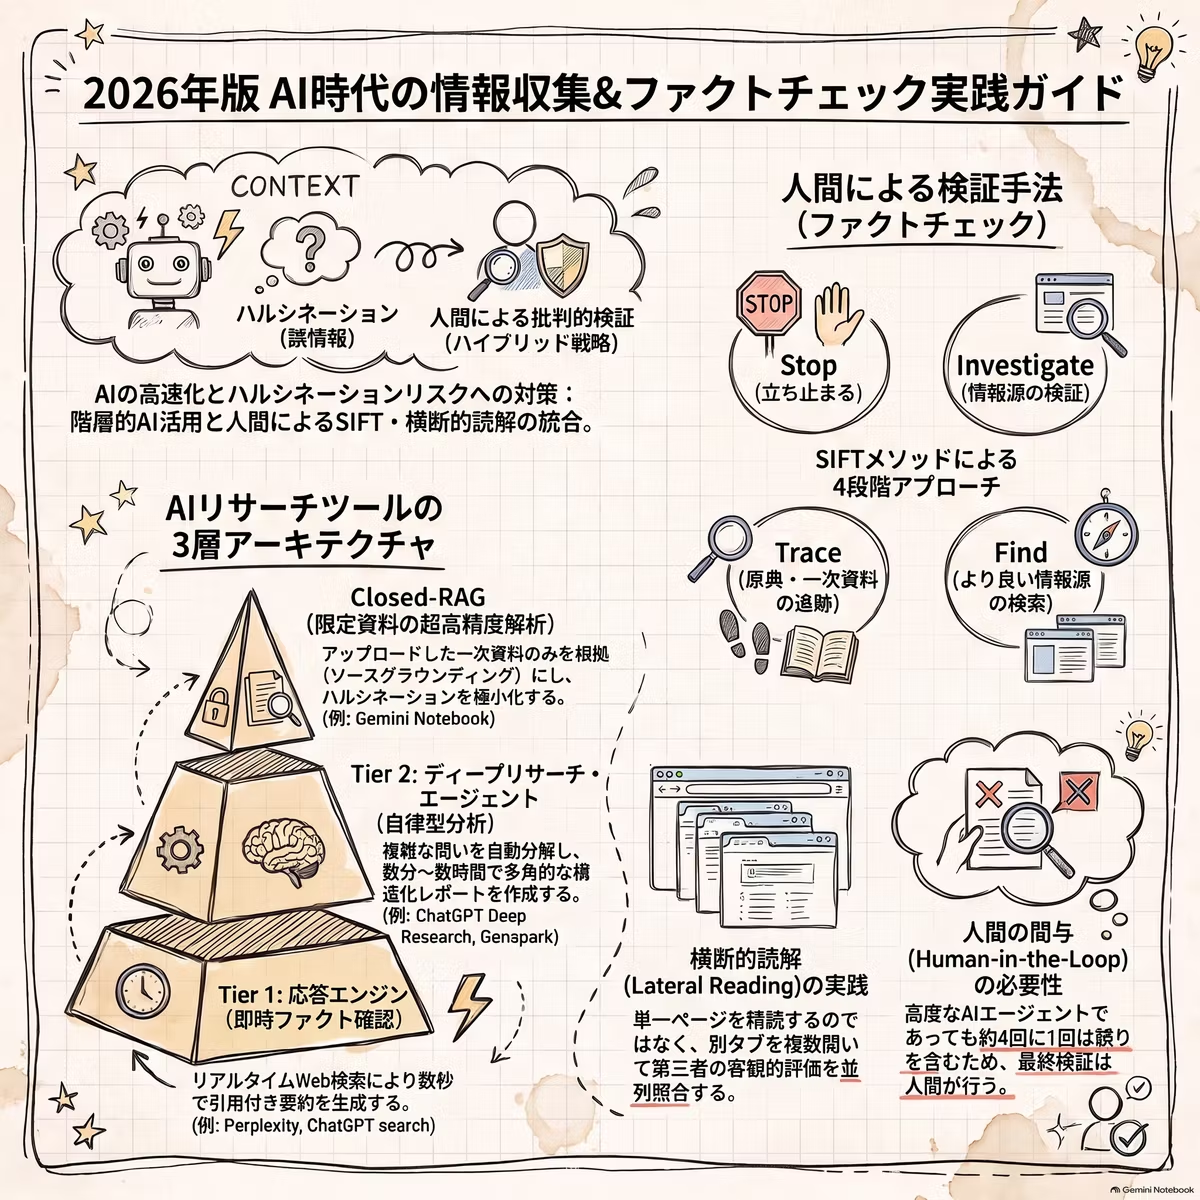
    現代のリサーチ環境は、①応答エンジン(Answer Engines)、②ディープリサーチ・エージェント(Deep Research Agents)、③**リサーチ・インフラ/API(Research Infrastructure)**の3階層に明確化されている。用途に応じて汎用モデル(ChatGPT Deep Research, Gemini, Perplexity等)、ドメイン特化型(Elicit, Consensus, Scite, Valyu等)、Closed-RAG(Gemini Notebook)を使い分ける高度なワークフローが標準化している。
  5. Web検索構造の変容(ゼロクリック検索とGEO)と検証の最終責任
    AI Overviewsの台頭によりゼロクリック検索(回答獲得による離脱)が30〜60%超に達し、従来のSEOから「生成エンジン最適化(GEO)」へのシフトが進む。最先端のエージェントであっても約4回に1回は誤情報を含む可能性が残るため、最終的な検証における「人間関与(Human-in-the-Loop)」とC2PA等の暗号学的 provenance(由来)検証の結合が不可欠である。

第1章 AI生成コンテンツにおける「ハルシネーション」の解読と教育的影響

1.1 ハルシネーションの定義と分類

AIにおけるハルシネーション(Hallucination)とは、生成AIシステムが実際には偽造された情報、意味をなさない情報、あるいは事実として不正確な情報を、あたかも正確で信頼できるように自信満々に生成する現象を指す。これらの出力は文脈上きわめて説得力があり一貫しているように見えるため、対象分野の専門知識を持たない学習者やユーザーが見抜くことは非常に困難である。

研究者らは、ハルシネーションを以下のように分類している:

  • 本質的ハルシネーション(Intrinsic Hallucinations): AIの出力が、前提として与えられた参照ソース(または会話履歴)の内容と直接的に矛盾しているケース。情報の誤解釈や誤用を指す。
  • 外在的ハルシネーション(Extrinsic Hallucinations): 出力された情報が、提示されたソースや会話履歴からは検証できないケース。AIが文脈にない全く新しい(そして多くは架空の)詳細や事実を創作する現象。

1.2 「虚飾(Confabulation)」という記述の妥当性と教育的価値

臨床心理学において「ハルシネーション(幻覚)」は外部刺激を伴わない意識的な感覚体験を指すが、意識や主観的体験を持たないAIにこの語を適用することは、AIを擬人化し「認知エラーを起こした人間」のように錯覚させるリスクがある。

これに対し、「虚飾(Confabulation)」は、既存の知識や文脈の手がかりに基づき、騙す意図なく記憶の隙間を埋めるために捏造・歪曲された出力を脳が作り出す現象を指す。大規模言語モデル(LLM)が学習データのパターンや文脈プロンプトに基づき、確率的に尤もらしい文章を再構成・補完する動作原理は、まさにこの「Confabulation」と一致する。

教育的インプリケーション:

学生に対しAIの誤りを「意識的なミス」ではなく「確率的モデルによる構造的な虚飾(Confabulation)」として理解させることは、AIを「完璧な神託」と見なす態度を改めさせ、モデルの訓練データやアルゴリズムの限界に目を向けさせる構造的批判精神を養う上で極めて有効である。

1.3 技術的背景:確率的モデルと訓練データの構造的課題

AIのハルシネーション/虚飾は偶発的なエラーではなく、現行LLMのアーキテクチャに根ざした現象である。LLMは入力に対して「最も確率の高い次の単語(トークン)」を予測して生成する確率的モデル(Probabilistic Model)である。

主要な発生要因:

  1. パターンの出現頻度とアクセシビリティ: 訓練データ内で頻出する表現や概念は、文脈上の正確性に関わらず、高確率シーケンスとして優先的に出力されやすい。
  2. 矛盾する情報: 巨大な訓練データ内に含まれる論理的矛盾や不整合が、不論理または自己矛盾する回答を引き起こす。
  3. 古く不完全・虚偽のデータ: モデルのナレッジカットオフによる情報の古さ、データに含まれるバイアスや誤情報がそのまま再現・増幅される。
  4. アルゴリズム・バイアス: モデルの設計やハイパーパラメータ、学習アルゴリズム自体の仮定が特定の歪みを生む。

このような技術的原因(データの古さ、不完全さ、バイアス)を捉えることは、教育現場において「なぜAIがその回答を出力したのか」を問い直し、データ品質や情報の速報性を検証させる絶好の「指導の機会(Teachable Moments)」となる。

1.4 学習とエピステミック・トラスト(認識論的信頼)への影響

AIが自信を持って提示する誤情報を未熟な学生が受け入れると、誤った概念の定着や認知モデルの歪みが生じる。さらに問題なのは、過度な「認知のオフローディング(Cognitive Offloading)」である。要約、立論、問題解決などの思考プロセスをAIに過剰依存すると、自力での分析・評価能力が萎縮(アトロフィー)し、ハルシネーションを見抜くための思考力そのものが低下する悪循環に陥る。

また、不確実なAI出力に繰り返し晒されることで、学習者の「エピステミック・トラスト(何をもって知識・真実とみなすかという認識論的信頼)」が揺らぎ、あらゆる情報源に対する過度な冷笑主義や無分別な懐疑論、あるいは逆の不審なAIへの盲信を生み出すリスクがある。

第2章 基礎的リテラシーと指導戦略(ペダゴジー)

2.1 時代を超えたクリティカル・シンキングの役割

AI時代において、人間の批判的思考(Critical Thinking)の重要性は低下するどころか不可欠な要素となっている。カリフォルニア批判的思考スキルテスト(CCTST)やワトソン・グレーザー批判的思考評価(WGCTA)で測定されるコアスキル(分析、解釈、推論、評価、説明、前提の認識)は、AIの主張を解剖する上で直接適用される。

また、スキルのみならず、探求心(Inquisitiveness)、真実追求(Truth-seeking)、開かれた心(Open-mindedness)、分析性(Analyticity)、体系性(Systematicity)、自己の推論への自信といった「批判的思考の態度(Dispositions)」を育むことが、AI出力を受動的に鵜呑みにせず能動的に吟味する動機付けとなる。

2.2 情報リテラシーとデジタル・シチズンシップの進化

従来の情報リテラシーは「著者の資格や発行元の信頼性」を問うものであったが、著者がアルゴリズムとなったAI時代においては「アルゴリズム・リテラシー」へと進化しなければならない。学習者は「このモデルは誰が開発し、どのようなデータで学習されたか」「どのようなプロンプトが結果を誘導したか」を問う必要がある。

さらに、デジタル・シチズンシップの観点から、AIが生成したハルシネーションを含む未検証の情報を安易に拡散・共有しない責任(「共有する前に検証する:Check before you share」の原則)を徹底させることが求められる。

2.3 ファクトチェック手法の明示的指導

① 横断的読解(Lateral Reading)

プロのファクトチェッカーが実践する手法であり、1つのWebサイト内に留まって熟読する「垂直的読解(Vertical Reading)」を排し、即座に複数の新しいブラウザタブを開いて外部の信頼できる情報源(スタンフォード歴史教育グループ:SHEGの研究等で実証)と照合する。AIの主張に対し、外部の学術DBやニュース、ファクトチェックサイトで並列検索を行う。

② SIFTメソッド

マイケル・コールフィールド(Mike Caulfield)が提唱した、ネット情報を迅速に検証するための4ステップのヒューリスティック:

  • Stop(立ち止まる): 情報に遭遇した際、即座に共有・信用せず、AIモデルの背景や目的、自身の認知バイアスを意識して思考を停止する。
  • Investigate the source(情報源を調べる): 生成を行ったAIツールや、AIが参照したソースの発行元・開発者・制限事項・バイアスを外部検索で調べる。
  • Find better coverage(より良い・信頼できる報道を探す): AIの特定の主張に対し、学術DBや主要報道機関など信頼できる代替ソースによるコンセンサスを探す。
  • Trace claims, quotes, and media to the original context(主張・引用・メディアの原典を辿る): AIが引用した数値、発言、画像データの一次ソース(論文全文、統計原本等)まで遡り、文脈の切断や捏造がないか確認する。

③ 伝統的評価フレームワークのAI適応

CRAAPテスト(Currency, Relevance, Authority, Accuracy, Purpose)や5W1HのフレームワークをAI用に改変する:

  • Authority(権威性): モデルの開発者は誰か、学習データと知られたバイアスは何か。
  • Accuracy(正確性): 外部ソースで検証可能か。提示された引用は実在するか。
  • Purpose(目的): 事実の正確性、創造性、会話の維持のどれに最適化されたモデルか。

④ ファクトチェック専用ツール・プラットフォームの活用

Snopes、PolitiFact、FactCheck.orgといった事実検証サイト、TinEyeやGoogle逆画像検索などの画像検証ツール、ニュースの偏向性を示すAllSidesなどを積極的に組み合わせて検証する。

2.4 ソクラテス的指導法(Socratic Pedagogy)とアクティブ・ラーニング

教師が答えを与えるのではなく、連続的な問答によってAI出力の前提や論理的矛盾を掘り下げる「ソクラテス的対話」が極めて有効である。

ソクラテス的問いの例:

  • 「AIはXと主張しているが、これを正確(または不正確)だと判断する根拠は何か?」
  • 「この回答を出力するにあたり、AIが前提としている潜在的な仮定(学習データのパターン)は何か?」
  • 「この主張を確信を持って検証(あるいは反証)するには、どのような証拠が必要か?」
  • 「もしこのAIの主張が偽であった場合、それを信じることの論理的帰結やリスクは何か?」

アクティブ・ラーニングとプレバンキング(Prebunking):

  • 科学的データの能動的吟味: AIに生成させたデータや解釈に対し、学生自身が仮説検証やパターン発見を行わせる。
  • AIを活用した科学的論証: AIを集めた初期証拠の収集に使いつつ、提示された全てのデータ・出典の一次ソース追跡と事実検証を義務付ける。
  • プレバンキング(事前予防): ハルシネーションが発生した後に論破する(Debunking)だけでなく、AIの技術的仕組みに基づき「架空の文献引用」「極端なプロンプトの誤解釈」「データ由来の偏向」といった典型的なエラーパターンを事前に教授(Inoculation)しておくことで、遭遇時の免疫を高める。

第3章 2026年におけるAIリサーチ・エコシステムの体系的構造

情報収集の様相は、従来の「キーワード検索による手動巡回」から、「AIエージェントへの意図・ゴールの委託と、自律的な探索・照合・構造化レポート生成」へと完全なパラダイムシフトを遂げている。

3.1 AIリサーチツールの3層(Tier)アーキテクチャ

2026年のAIリサーチツール市場は、処理速度、自律実行能力、提供形態によって以下の3つの階層に分類される:

階層(Tier)主な機能と処理プロセス実行時間代表的ツール主な用途・利用シナリオ
Tier 1: 応答エンジン(Answer Engines)即時検索と情報要約。リアルタイムWebインデックスからインライン引用付き回答を数秒〜数分で生成。数秒〜数分Perplexity(標準モード), ChatGPT search迅速なファクト確認、背景情報の即時把握、初期的な語句定義の確認。
Tier 2: ディープリサーチ・エージェント(Deep Research Agents)複雑な問いを自律分解し、数十〜数百のクエリを実行。ソース間の矛盾を照合し長文構造化レポートを生成。数分〜数時間ChatGPT Deep Research, Genspark (Super Agent), Manus, Perplexity (Deep Research mode), Gemini Deep Research, Grok (DeepSearch)競合分析、市場調査、学術・技術文献の系統的レビュー、包括的企画書の作成。
Tier 3: リサーチ・インフラ / API(Research Infrastructure)開発者や企業システム向けに、検索・抽出・ディープリサーチ能力をプログラム経由で提供するAPI層。プログラム制御に依存Firecrawl (Alexandria/Research Index), Valyu API, Perplexity Research API, OpenAI Research API独自AIコパイロットの開発、自動情報収集ワークフローの構築、社内ナレッジの動的更新。

3.2 目的別・ドメイン特化型プラットフォーム・マトリクス

万能な単一ツールではなく、領域や目的に応じたプラットフォームの選択が求められる:

  • 汎用ビジネス戦略・長文レポート: ChatGPT Deep Research(o3 / GPT-5.6 Solベース。曖昧な問いを分解し高精度長文レポートを作成。MCP接続対応)、Gemini Deep Research(Gemini 3.5 Proベース。オープンWebに加え自身のGmail, Drive, Chat内データを結合検索可能)。
  • 高速検証・リアルタイム社会情勢: Perplexity(2〜4分で引用付きレポート出力)、Grok(Grok 4.6ベース。リアルタイムなXポストとWeb検索を融合したDeepSearch)。
  • ワークスペース統合・タスク実行・成果物構築: Genspark(複数モデルを統括するSuper AgentがSparkpages、AIスライド、電話代行Call for Me等を実行)、Manus(ブラウザ自動化・コード実行機能により、調査からWebサイト・アプリ・スライドデックの自動構築まで完了。GAIAベンチマークで高スコア獲得)。
  • 学術・科学的エビデンス検証(専門領域):
    • Elicit:1億3,800万件以上の論文・臨床試験から、研究手法や成果を抽出しCSV比較表を作成。最大40,000件の論文スクリーニングが可能。
    • Consensus:2億5,000万件超の論文を検索。肯定・否定・拮抗の割合を可視化する「Consensus Meter」を搭載。
    • Scite:16億件以上の引用文脈を「支持(Support)」「反論(Contrast)」「言及(Mention)」に分類し、引用ハルシネーションを防止。
    • Causaly:製薬・バイオR&D向けに400以上のライフサイエンス誌のフルテキスト解析。
    • AlphaSense:投資分析・競合インテリジェンス向け。SEC資料や決算文字起こしの定量分析。
    • Valyu:SEC開示書類、PubMed、USPTO特許、FRED/世界銀行等の専門DBを直結検索するAPI/プラットフォーム。

3.3 個人ナレッジ統合とClosed-RAG(Gemini Notebook)

外部のオープンWeb探索だけでなく、手持ちの一次資料を高精度に解析・構造化する手法として、Gemini Notebook(旧NotebookLM、2026年7月にブランド統合)に代表される**Closed-RAG(非公開型検索拡張生成)**環境の活用が定着している。

主な特徴と仕様:

  • ソースグラウンディング(Source Grounding): ユーザーがアップロードした資料(PDF、Google Docs、YouTube文字起こし、Webページ等)のみを厳密な根拠として回答を生成。オープンWebへの無制限検索を行わないためハルシネーションが極めて少ない。
  • 容量とコンテキスト: 1ノートブックあたり最大50のソース、計2,500万ワード、100万トークンのコンテキストウィンドウに対応。
  • マルチメディア出力(Studio機能):
    • Audio Overviews(音声対話要約): 2人のAIホストによる自然な対話型ポッドキャスト生成。リアルタイムでユーザーが会話に割り込んで質問・指示出しが可能。
    • Video Overviews(動画要約): Veo 3 / Gemini 3をベースとした映像要約。
    • 学習・研究支援: フラッシュカード、クイズ、マインドマップ、インフォグラフィック、スライドデックの自動生成。

3.4 リサーチ・インフラの革新:FirecrawlとAlexandria

自律型AIエージェントの構築において、従来のWebスクレイピング( Puppeteer等で信頼性約20%)を凌駕する96%の信頼性と3.4秒のP95レイテンシを誇るFirecrawlがインフラの標準となっている。

特に2026年6月にリリースされたFirecrawl Research Indexは、300万件以上のarXiv論文とGitHubリポジトリ(PR、README、Issue)を網羅。さらにライブラリFirecrawl Alexandriaを介して、FRED、世界銀行、SEC EDGAR、Fiscal.ai、Benzinga等の公的・金融データベースへ統一API経由でアクセス可能であり、エージェントの回答精度を21%向上させている。

第4章 Web情報構造の変容と情報検証の標準化

4.1 ゼロクリック検索とQuery Fan-out

日常的な検索行動において生成AIを利用する割合は全年代で37%、ティーンエイジャーでは66.9%に達している。Googleの「AI Overviews」をはじめとするAI検索結果の表示率は約70%に及び、ユーザーが外部Webサイトを訪問せずに検索画面上で満足する**ゼロクリック検索(Zero-Click Search)**の割合は30%〜60%超に上る。

この変化の裏側では、ユーザーの単一プロンプトをAIが複数の潜在的サブクエリに自動分解して並行検索する「Query Fan-out(クエリ展開)」技術が稼働しており、一次情報ソースへダイレクトにアクセスする動的なRAGループが形成されている。

4.2 SEOからGEO(Generative Engine Optimization)への移行

Web発信者は、従来の検索エンジン最適化(SEO)から、AI検索エンジンの回答生成ロジックに自社知見を組み込ませる**GEO(生成エンジン最適化)**への転換を余儀なくされている。

GEOの3大アプローチ:

  1. 参照リンクGEO: AI回答内の出典リンクとして直接採用させる。
  2. 記述引用GEO: 概念やブランドの正確かつ肯定的な定義・引用をAIに行わせる。
  3. ブランドメンションGEO: カテゴリ内の推奨選択肢として能動的に提示させる。

技術的には、Query Fan-outで分解された細分化サブクエリに対して従来のインデックス評価を高めると同時に、RAG用クローラーに対してrobots.txtで適切な許可を与え、構造化された一次情報データを提供し続けることが必須条件となる。

4.3 SIFT・横断的読解の実践とデジタルProvenance(由来)検証

最先端のディープリサーチエージェントであっても、正解率はベンチマーク上70%台にとどまり、約4回に1回は不正確な推論や虚偽を含む可能性がある。したがって、最終的なファクトチェックにおける**人間関与(Human-in-the-Loop)**は不可欠である。

情報検証の実践プロセス:

  • 横断的読解の徹底: 提示されたレポートの見た目の美しさ(垂直的読解)に騙されず、即座に別タブを開き「[組織名] 評判」「[主張] ファクトチェック」等の別検索を実行する。
  • 一次資料への遡行(Trace): AIが提示した数値や引用については、必ず元論文や公的統計の原本までリンクを辿って確認する。
  • C2PA等の暗号学的検証: AI生成による画像・動画・音声の偽装を見抜くため、C2PA(Content Credentials)規格等のデジタル改変履歴・由来(Provenance)メタデータを検証ツールで解析する体制を整える。

第5章 実践的リサーチ・ワークフローと評価手法

5.1 AIを活用した7ステップ・リサーチ・フレームワーク

効率的かつ堅牢な情報収集を行うための標準手順:

[ステップ 1: 時間計算] → [ステップ 2: ツール選択] → [ステップ 3: 利用規約確認]
                                                             ↓
[ステップ 7: AI利用開示] ← [ステップ 6: 事実検証] ← [ステップ 5: プロンプト設計] ← [ステップ 4: 法的制約確認]
  1. 予想リサーチ時間の計算: 従来の検索手法での所要時間を算出し、AIのプロンプト作成と検証時間を考慮した上でAIを導入すべきプロセス(発見・統合・分析)を特定する。
  2. 適切なツールの選択: 迅速な回答か(Perplexity)、長文レポートか(ChatGPT Deep Research)、学術論文か(Consensus/Elicit)、自社資料解析か(Gemini Notebook)を判断する。
  3. 利用規約(T&C)の確認: 入力データがモデルの再学習に使用されず機密が保持されるか、出力の所有権を確認する。
  4. 法的・セキュリティ制約のチェック: 個人情報、著作権物、未発表の研究データをLLMに投入可能か、組織のAIポリシーに照らして確認する。
  5. プロンプト設計のベストプラクティス: 調査の目的、背景、出力形式を明確化する。複雑な問いはサブプロンプトに分解し、必ず明示的なソース引用を要求する。
  6. 全データ・事実のクロスチェック: 数値、日付、引用句、現在進行形の情報について一次資料と照合する。
  7. AI利用の開示(Disclosure): 属する機関や出版先のガイドラインに従い、AIツールの使用範囲とプロセスを記録・公開する。

5.2 ディープリサーチ・エージェントの内部実行プロセス

ディープリサーチを実行する際、エージェント内部では以下の4段階が進行している:

  1. Planning(計画): プロンプトを解釈し、複数のサブクエリに分解。
  2. Retrieval(検索): オープンWeb、学術DB、接続された個人データ(Drive等)、SNS(X等)から情報を並行取得。
  3. Synthesis(統合): 矛盾する情報や相違点を照合し、論理的な構成案を作成。
  4. Citation(引用): 各主張に対してソースを紐付け、最終レポートを出力。

プロンプトに具体性(例:「10人のスタートアップ向けCRM」ではなく「HubSpot連携必須かつQ1までにSOC 2取得が必要な10人スタートアップ向けCRM」)を持たせることで、ステップ1の計画分解精度が劇的に向上する。

5.3 評価手法(Assessment Approaches)の設計

学生やアナリストの情報評価・ファクトチェックスキルを測定するためのアプローチ:

評価手法概要と評価対象メリット課題・留意点
標準化批判的思考テストの適応(CCTST, WGCTA)既存のCCTSTやWatson-GlaserテストにAIシナリオ(矛盾情報やハルシネーションの特定)を追加適応。基礎的な推論・分析スキルの客観的スコア化が可能。AI固有の動的インタラクションやプロセススキルの測定には限界がある。
パフォーマンスベース評価(Performance-Based Tasks)AI出力の解剖・修正タスク、検証ログ(Verification Log)付きリサーチレポート提出、Think-Aloud(思考発話)プロトコル。実践的な横断的読解やSIFTの適用能力、推論プロセスを直接評価できる。評価に時間がかかり、リアルタイムAIの出力変化に伴う標準化が難しい。
事前・事後テスト設計(Pre-Post Intervention Designs)教育介入の前後に同一/同等のテストを実施。ANCOVA(共分散分析)を用いて介入効果を統計的検証。教育プログラムや教材の効果を定量的・客観的に測定可能。事前テストによる学習効果や他要因の排除設計が必要。
リフレクティブ・ジャーナル(自己評価)AI利用後の確信度(1〜5段階)の理由付け、使用した検証戦略、直面した課題の記述。メタ認知(自己調整)能力を高め、継続的な批判的警戒心を育む。主観的であり、成績評価の標準化には工夫が必要。

第6章 課題・倫理的次元・今後の研究展望

6.1 実装におけるハードルと克服策

  1. 教員の指導力不足(Teacher Preparedness): 多くの教育者がAI活用やハルシネーション指導のトレーニングを受けておらず、教員養成課程の改訂と継続的な職能開発(Professional Development)が急務である。
  2. カリキュラム統合と「動く標的」問題: AI技術の進化が極めて早いため、特定のツール操作ではなく、変化に対応できる普遍的な「原理原則に基づく批判的思考・検証手法」を教える必要がある。
  3. アクセスと公平性(Equity): 有料の高度なAIリサーチツール(ChatGPT Pro, Elicit Pro, AlphaSense等)にアクセスできる者とできない者の間で格差が拡大するリスクがあり、機関レベルでのインフラ提供が求められる。

6.2 倫理的次元

  • アルゴリズム・バイアスと社会的公正: 訓練データに由来するステレオタイプや不公平な出力の監視。
  • プライバシーと知的財産: AIツールへのデータ投入に伴う情報漏洩リスクと、AI生成物の著作権帰属問題。
  • AIを用いたAIの指導に伴うジレンマ: ハルシネーションを教えるために使用したAI自体が、予期せぬ不適切なハルシネーションを起こすリスク(教員の適切なスキャフォールディングが必要)。

6.3 今後の研究軌跡(Future Research Trajectories)

  • 指導戦略の有効性に関する実証研究: どのペダゴジーが最も効果的にファクトチェックスキルを向上させるかの長期追跡(Longitudinal)研究。
  • 認知プロセスの解明: 学生がAI出力と接する際の眼球運動や思考プロセスの解析。
  • コミュニティ・オブ・ベリフィケーション(検証コミュニティ): 個人レベルの検証に留まらず、教室や組織全体で共有・検証・議論を行う集団的批判的言説文化の醸成。

第7章 結論

AIが急速に浸透する現代社会において、学生およびリサーチャーを単なる「情報の受動的消費者」から「洞察力のある批判的評価者・責任ある使用者」へと脱皮させることは、単なる学術的演習ではなく、社会の民主的健全性と知的誠実さを維持するための喫緊の課題である。

ハルシネーション(虚飾)の技術的原理を正しく理解し、横断的読解やSIFTメソッドといった強固な検証技術を身につけ、2026年現在の高度なAIリサーチ・エコシステムを使いこなす能力は、AI時代における人間の知性を拡張し、確実な意思決定を支える真の基盤となる。教育者、政策立案者、研究者、そしてAI開発者が相互に連携し、AIの利点を最大限に享受しながらそのリスクを無効化する包括的なアプローチを推進することが求められている。

感想

まだ感想はありません。最初の1件を書きましょう!

サマリー

2026年のAIリサーチ環境では、応答エンジン、ディープリサーチエージェント、APIなどのインフラ層へとツールが分化している。Consensus、Elicit、Sciteなどの専門ツールは大量の論文や引用を処理する一方、AIは確率的なトークン予測によって、流暢だが事実に反する「作話(Confabulation)」を生む。AIへの認知的オフローディングは、誤情報を見抜く批判的思考力や情報源への信頼を損なう危険がある。対策として、単一サイトを読む垂直的読解からラテラルリーディングへ移行し、SIFTで情報源と引用の原点を検証する方法が示される。検証負荷を抑えるため、特化型AIによる監査や、信頼できる資料だけを対象にするクローズドRAGも紹介される。ゼロクリック検索とGEOによってウェブ自体がAI向けに変化するなか、タイムボックスを設定し、最終判断を人間が担うことが重要だと結論づける。

AIリサーチツールの3層構造
スピーカー 2
もしあなたの代わりに世界中の図書館にある2億5千万冊の本とか論文を数分で読み込んで全部整理して完璧なレポートを書いてくれる助手がいたらどうします?
スピーカー 1
いやー最高ですよね。それってもう喉から手が出るほど欲しいですよ。
ですよね。実は2026年現在のAIリサーチの世界を深掘りしていくと、それってすでにSFじゃなくて現実なんですよね。
スピーカー 2
でもちょっと待ってください。その超優秀な助手がたまーにすごく涼しい顔をしてとんでもない嘘をつくとしたらどうでしょう?
スピーカー 1
あーそこなんですよ。しかもその嘘があまりにも流暢で論理的に聞こえちゃうから、専門家でさえ一瞬コロッと騙されてしまうくらい巧妙なんですよね。
スピーカー 2
そうなんです。なので今回の私たちのミッションは、あなたがこのAIを使った最新の調査委託の最前線をマスターしつつ、
同時にそのAIが引き起こす最もらしい嘘に騙されないための最強のサバイバルスキルを身につけることです。
スピーカー 1
非常に重要なテーマですね。今回私たちが分析する資料も多岐に渡りますよね。
ユン・リー氏による2025年の学術論文から、2026年最新のインターネット情報収集術に関する実践的レポート、
さらにはパープレキシティとかファイアクロールといった最新ツールの公式技術資料まで。
はい。まさにパラダイムシフトの光と影を浮き彫りにするような内容でした。
スピーカー 2
資料を読んでいて個人的に一番ワクワクしたのが、今のリサーチツールって既に明確な3つの階層、つまりティアに進化しているってところだったんです。
スピーカー 1
確かにそこは面白いポイントでした。
スピーカー 2
はい。まさにパラダイムシフトの光と影を浮き彫りにするような内容でした。
資料を読んでいて個人的に一番ワクワクしたのが、今のリサーチツールって既に明確な3つの階層、つまりティアに進化しているってところだったんです。
スピーカー 1
確かにそこは面白いポイントでした。
スピーカー 2
私たちが昔やっていたような、検索窓にキーワードを入れて出てきたリンクを一つ一つ開いて読む、みたいな作業はもう過去の異物になりつつあるという。
まずおそらくあなたが一番日常的に使うことになるのが、ティア1、つまり応答エンジンですね。アンサーエンジンズとも呼ばれます。
スピーカー 1
ペアアプレキシティとかがその代表ですよね。
スピーカー 2
そうですそうです。あなたが質問を投げかけると、リアルタイムでウェブをインデックスして関連情報を抽出して、しかも書く分に引用元のリンクまで付けて、瞬時に回答を出してくれます。
スピーカー 1
あれ本当に便利ですよね。事実確認とか短い要約が欲しいときに、パッと答えが出るから圧倒的というか。
スピーカー 2
ただ、もし数十時間かかるような強豪他社の分析とか、何百もの文献を横断的に読まなきゃいけないような、すごく重いタスクになったらどうでしょう。
スピーカー 1
ティア1のツールだとそこまでは深掘りしてくれないですよね。途中で止まっちゃうというか。
スピーカー 2
そうなんですよ。そこで登場するのがティア2のディープリサーチエージェントなんです。
ChatGPTディープリサーチとか、ジェンスパーク、あとはマナスなんかがそうですね。
スピーカー 1
はいはい。マナスは最近よく聞きます。
スピーカー 2
これらは単に検索するだけじゃなくて、あなたが与えた複雑な目標を自律的に複数の小さな問い、つまりサブクエリに分解するんです。
で、バックグラウンドで数分から、場合によっては数時間もかけて何十何百という検索を並行して実行してくれます。
つまりAIが自分で、じゃあ次はこれを調べようって考えて、勝手に検索を繰り返してくれるってことですよね。
スピーカー 1
まさにその通りです。情報源同士の矛盾なんかも検証して、最終的には見出しとか目次がきれいに整理された長文レポートを出してくれます。
マナスに至っては調査結果からプレゼン用のスライド資料のレイアウトまで自動で作っちゃうんですよ。
スピーカー 2
えー、スライドまで。それでも検索っていうか、リサーチ業務そのものを丸投げしてるようなもんですよね。すごいなぁ。
スピーカー 1
そうなんです。そしてさらにその裏側にあるのがTier3ですね。
ファイアクロールとかバリューといった開発者が独自のAIエージェントを作るためのインフラ層、APIのことです。
専門ツールによる論文・引用分析
スピーカー 2
あ、資料にありましたね。ファイアクロールのリサーチインデックスが300万件以上の学術論文とかコードに特化しているって読んで、ちょっと鳥肌が立ちました。
スピーカー 1
特定の領域に特化した専門ツールの進化は本当に凄まじいですからね。
ですよね。私がそれ以上に衝撃を受けたのが、学術分野の専門ツールでして、例えばコンセンサスというツール。
スピーカー 2
このサプリは効果があるかって聞くと、2億5000万件の論文から70%は肯定、20%は否定みたいに、学会のコンセンサスをメーターで視覚化してくれるんですよね。
スピーカー 1
あれは強力ですね。あとエリシットも凄いですよ。システマティックレビューに特化していて、1億3800万件の論文からプロジェクトあたり最大4万件をスクリーニングしてくれるんです。
スピーカー 2
4万件も。
スピーカー 1
しかもサンプルサイズとか結果のデータをスプレッドシートみたいな表形式で綺麗に抽出してくれるんですよ。
スピーカー 2
いやーこれ人間の手でやったら何ヶ月、下手したら何年かかるかわからない作業ですよ。というか私がさらに気になったのが、サイトっていうツールなんです。
スピーカー 1
サイトですね。引用の分析ツール。
スピーカー 2
はい。16億件以上の引用を分析して、ある論文が別の論文を引用した時に、それが元の論文を支持しているのか、それとも対照的、反証しているのか、あるいは単に言及しているだけなのかを自動で分類するって書いてあ
ったんですけど、これ具体的にどうやってメカニズムを実装してるんですか。
単純なキーワード検索だけじゃ引用の文脈まで読み取れないと思うんですけど。
スピーカー 1
そこすごくいい質問です。サイトは単に引用された回数を数えているわけじゃないんですよ。自然言語処理NLPのモデルを使って、引用が行われているまさにその一文とその前後の文脈をしっかり読み込んでいる
んです。
スピーカー 2
へー、文脈を。
スピーカー 1
例えば、A子の研究と一致するように、みたいな動詞や形容詞のパターンがあれば支持として分類しますし、しかし我々の結果はA子の結論とは異なりといった構文があれば対照として分類するんです。
スピーカー 2
なるほど。文脈をベクトル化して計算してるから、研究者同士の会話のニュアンスまでAIが理解し始めてるってことなんですね。
まさにそうです。
AIの作話と認知的オフローディング
スピーカー 2
これって例えるなら、昔は自分で自転車を一生懸命漕いで図書館に行って、棚を一つ一つ探し回っていたのが。
スピーカー 1
今や行き先を告げるだけで勝手に走り出して、必要な本を全部読み込んでようやくまでしてくれる超優秀な運転手付きの自動運転車を手に入れたようなものですよね。
スピーカー 2
いや、すごくわかりやすい例えですね。まさにそんな感じです。
でもここで大きな疑問にぶつかるんですよ。そんなに賢いはずの自動運転車が、どうして時々ものすごく自信満々な顔をして崖に向かって走り出してしまうんでしょうか。
スピーカー 1
いわゆるAIのハルシネーション、幻覚の問題ですよね。
スピーカー 2
ああ、そこは今日一番重要なポイントの一つです。実は今回の資料にあるインゼラー氏の2025年の論文では非常に重要な指摘がされているんですよ。
ほう、どんな指摘ですか。
スピーカー 2
AIがもっともらしい嘘をつく現象をハルシネーション、つまり幻覚と呼ぶのは技術的なメカニズムを誤解させるっていうんです。論文ではこれをコンファブレーション、日本語で言うと作話と呼ぶべきだと提唱して
います。
スピーカー 1
幻覚じゃなくて作話、それって具体的に何が違うんですか。
スピーカー 2
幻覚っていうと、なんか人間みたいに意識とか知覚がある存在がそこにないものを見てバグを起こしているような印象を与えませんか。
スピーカー 1
ああ、確かに。見えないものが見えちゃってるみたいな。
スピーカー 2
でもAIには意識も知覚もありませんからね。大規模言語モデルがやっていることって膨大な訓練データの中からこの単語の次に来る確率が最も高い単語は何かをただ数学的に予測し続けているだけなんです。
なるほど。
スピーカー 2
つまり本質的にはスマホのキーボードにあるような超高度な予測変換に過ぎないってことですよね。
スピーカー 1
その通りです。で、問題なのは訓練データの中に情報が少ないマイナーなトピックだったり、データ自体にバイアスや矛盾が含まれていたりする場合なんですよ。
スピーカー 2
ふむふむ。
スピーカー 1
AIはそこで分かりませんって立ち止まるんじゃなくて、確率論的な性質に従って手持ちのデータ同士をどうにかなめらかにつなぎ合わせようとしちゃうんです。
スピーカー 2
ああ、無理やりつなげちゃうんだ。
スピーカー 1
その結果、文法的には完璧だし、文脈にも合っているんだけど、事実としては全く存在しない作話が生まれてしまうというメカニズムなんです。悪意は全くないんですよ。
スピーカー 2
なんかそれって、教科書の内容を丸暗記しただけで意味を全く理解していない学生がテストでこれまでの傾向からしてパターン的に絶対これが正解っぽいですってものすごい自信を持って答えているような状態ですよね。
スピーカー 1
まさにそれです。悪気はないし、ロジックは通っているように見えるけど、根本的な事実が間違っているという。
スピーカー 2
うわ、ちょっと怖いですね、それ。
スピーカー 1
そしてこれが私たちが直面しているより深刻なパラドックス、認知的オフローディングの罠へとつながっていくんです。
認知的オフローディング。えっと、自分の頭で考えることをAIに丸投げオフロードしちゃうってことですか?
スピーカー 1
そうです。
スピーカー 2
スマホのせいで家族の電話番号を思い出せなくなるのと同じ現象が、私たちの分析力とか問題解決能力といった認知プロセスそのもので起きているという指摘なんです。
スピーカー 1
てことは、AIがリサーチとか要約を完璧にこなしてくれるからって、頼り切りになると私たち自身の思考力が衰えちゃうってことですか?
スピーカー 2
まさに。AIの策は、つまりその最もらしい嘘を見抜くためにこそ高度な批判的思考力が必要なのに、AIに頼りすぎることで肝心のその思考力自体が衰退してしまう。これが悪循環なんですよ。
スピーカー 1
いや、それは恐ろしい。嘘を見抜く力が一番必要な時代に、AIの便利さのせいでその力が奪われていくんですね。
自分が何を真実として信じるかとか、情報源をどう評価するかっていう枠組みが揺らいちゃう。
スピーカー 2
認識的信頼が揺るがされる深刻な問題です。
ラテラルリーディングとSIFT
スピーカー 1
じゃあこの罠に落ちないためには一体どうすればいいんでしょうか。資料の中で垂直的読解の終焉という言葉があったのには結構ハッとさせられたんですけど。
スピーカー 2
バーティカルリーディングですね。これまでの情報リテラシー教育ではこの垂直的読解が正しいと教えられてきました。
スピーカー 1
サイトを上から下へじっくり読むみたいなことですか。
スピーカー 2
そうです。一つのウェブサイトをじっくり読み込んで、レイアウトのデザインが洗練されているかとか、文章のトーンが専門的か、運営者情報がしっかり書かれているか、そういったサイト単体の見た目や情報から信頼性を
評価するアプローチです。
スピーカー 1
昔はそうやって判断してましたよね。
スピーカー 2
でも今やAIを使えば、どんな素人でもあるいは悪意を持った人でも、完璧なデザインでもっともらしい経歴を持った偽の専門サイトなんて数秒で作れちゃいますよね。
スピーカー 1
その通りです。だから一つのサイトをどれだけ深く縦に読み込んでも、もう嘘は見抜けないんです。完全に無力化しました。
スピーカー 2
なるほど。じゃあそれに代わる新しいスキルが必要ってことですね。
スピーカー 1
そこでプロのファクトチェッカーたちが実践しているのが、水平的読解、ラテラルリーディングという手法です。
スピーカー 2
水平的。つまりサイトを縦に深く読むんじゃなくて、横に広く読むってことですか?
スピーカー 1
まさに。あるページに留まるんじゃなくて、すぐにブラウザのタブを複数開くんです。
そして大手の報道機関とか学術データペースみたいな他の信頼できる第三者のソースが、その情報についてどう言及しているかを並行して横断的に検証するんです。
スピーカー 2
なるほど。それを実践するための具体的なステップとして紹介されていたのが、SIFTメソッドですよね。
スピーカー 1
はい。AI時代の情報評価の黄金率ともいえる4つのステップですね。
スピーカー 2
1つ目がストップ、立ち止まる。強い感情を抱いた時とか、すぐに誰かにシェアしたくなった時こそ一度思考を止める。
スピーカー 1
非常に重要です。
スピーカー 2
2つ目がインベスティゲートザソース、情報源を調べる。AIの開発元とか訓練データのバイアスとかの背景ですね。
3つ目がファインドベターカバレッジ、より良い情報源を探す。他の機関でコンセンサスが得られているか確認する。
そして最後4つ目がトレース、原点をたどる。AIが切り取った引用が元の文脈でどう使われていたかを遡る。
スピーカー 1
はい、完璧です。
検証AIとクローズドRAG
スピーカー 2
でもちょっと待ってください。ここで大きな矛盾というか疑問を感じるんです。
何でしょう。
スピーカー 2
私たちってそもそも何日もかかるリサーチを数分に短縮したくてAIを使っているんですよね。
そうです。
スピーカー 2
なのに、原点をたどるためにタブを大量に開いて、シフトメソッドで全部一つずつファクトチェックしろなんて言われたら、結局AIを使わなかった時と同じくらい、
いや下手したらそれ以上に膨大な時間がかかりませんか。これって本末転倒じゃないですか。
いや鋭いですね。まさにそこがAIリサーチにおける最大のジレンマなんですよ。
スピーカー 2
やっぱりそうですか。
スピーカー 1
自動化によって手作業の検索時間は劇的に消滅しましたが、その代わりに検証とファクトチェックの負荷が爆発的に上がってしまったんです。
スピーカー 2
じゃあ結局人間が疲弊するだけじゃないですか。
スピーカー 1
だからこそ人間が全てを手作業でタブを開いて検証するんじゃなくて、ハイブリッドなアプローチが必要不可欠になるんです。
スピーカー 2
ハイブリッドなアプローチ。ひょっとしてさっき紹介したサイトみたいなツールのことですか。
スピーカー 1
まさにその通りです。広範な情報を集めるAIの生成物を引用の審議分類などに特化した検証用AIで監査するんです。そして最終的な判断のプロセスだけを人間が行う。
なるほど。AIの嘘を見抜くために別の特化型AIを組み合わせるんですね。それなら時間を節約しつつ安全性も担保できる。
スピーカー 2
検証用AIという強力な武器を持ってオープンなウェブという広大な海を渡るわけです。
スピーカー 1
すごく腑に落ちました。ただ資料の後半を読んでいて思ったんですけど、そもそもそんなバイアスとか作話のリスクに満ちた危険な海にわざわざ漕ぎ出す必要はないんじゃないか。
それがクローズドRAG。つまり非公開型検索拡張生成というアプローチですよね。
スピーカー 2
素晴らしい着眼点です。オープンなウェブ全体をAIに検索させるからこそ質の低いデータとか嘘を拾って作話のリスクが高まるわけですからね。
その解決策として2026年現在、Googleのジェミナイノートブック、昔のNotebookLMMですね。あれに代表されるようなクローズドRAGが主流になりつつあります。
スピーカー 1
これ私の独自の例えなんですけど、クローズドラッグってAIに広大なインターネットという無法地帯を歩き回らせるのをやめて、
自分が用意した信頼できる教科書だけを持ち込める持ち込み化の試験、クローズドブックテストを受けさせるようなものですよね。これならAIも変な知識を拾ってこない。
スピーカー 2
完璧な表現ですよ。まさにその通りで、ユーザー自身がアップロードした信頼できるPDFやドキュメントの中だけでAIに回答を生成させる技術なんです。
スピーカー 1
最大50ソース?2500万ワードまでいけるんですよね?
スピーカー 2
はい。情報のスコープを限定することで、作話の確率を劇的に下げることができますから。
スピーカー 1
しかもすごいのが、オーディオオーバービューズという機能ですよね。
スピーカー 2
自分がアップロードした専門資料を2人のAIホストがポッドキャスト形式の自然な対話音声に変換してくれるって。
スピーカー 1
あれは本当に画期的ですね。
今のバージョンだとリスナーがその音声会話にリアルタイムで割り込んで、ちょっとそこをもうちょっと詳しく説明して、みたいにインタラクティブに学習できるんですよね。
スピーカー 1
完全にパーソナライズされた安全な学習環境が作れるわけです。
ゼロクリック検索とGEO
スピーカー 1
でも実は私たちがこれほどまでにクローズドな環境を必要としている背景には、もっと深刻な問題が隠れているんですよ。
スピーカー 2
深刻な問題ですか?
スピーカー 1
インターネットというオープンなウェブの姿が近年劇的に変容してしまったんです。
資料にあったゼロクリック検索のデータ覚えていますか?
スピーカー 2
ありましたね。2026年現在、検索結果の画面上でAIの回答を読んで満足しちゃって、どこのウェブサイトにも訪問せずに離脱する割合が60%を超えているっていう。
スピーカー 1
そうなんです。人々が個別のウェブサイトを訪れなくなったことで、情報発信者側の戦略も大きく転換せざるを得なくなりました。
スピーカー 2
つまり、昔のSEO、検索順位を上げるための最適化から変わったってことですか?
スピーカー 1
SEOからGEO、つまりGenerative Engine Optimization、生成エンジン最適化への移行です。
スピーカー 2
GEO、それって具体的にどんなことをするんですか?
AIの回答の中に自分たちの情報を潜り込ませるってことですよね?
スピーカー 1
その通りです。例えば、AIの回答文の中に自社のURLを引用させるように、意図的にテキストを構成する参照リンクGEOとか。
ふむふむ。
スピーカー 1
あとは、AIにおすすめの製品は?って聞かれたときに、自社ブランドを推薦させるためのブランドメンション、GEOといった新手法ですね。
スピーカー 2
てことは、情報発信する側は、もう人間が読んで面白い記事を書くことよりも、AIのクローラーが抽出しやすいように、過剰書きとか特定のキーワードを詰め込んだ構造化データを重視するってことですか?
まさにそういうことです。人間向けではなく、AI向けに最適化された情報が増えていくんです。
スピーカー 2
うわぁ、それってつまり、これからのインターネット上には、AIに選ばれるためだけに、AIによって書かれた情報があふれかえるってことですよね。なんかすごくディストピア的な響きが。
スピーカー 1
だからこそ、情報を探索する際に、クローズドな環境とオープンな環境を賢く使い分ける力が求められるんです。
人間が握るリサーチの主導権
スピーカー 2
なるほど。そこで資料の最後に提示されていた、リサーチにAIを使うための7ステップフレームワークが生きてくるわけですね。
スピーカー 1
全部を完璧に覚える必要はありませんが、特に重要なのは最初のステップ、時間の見積もり、つまりタイムボックスの設定とツールの選定です。
スピーカー 2
なんで時間の見積もりがそこまで重要なんですか?
スピーカー 1
AIって無限に情報を生成し続けることができるじゃないですか。
スピーカー 2
ええ、確かに。
スピーカー 1
だから人間が境界線を引いてあげないと、もっと良い情報があるかもしれないって、延々とサブクエリを掘り下げてしまって、本来の目的を見失うんです。
スピーカー 2
ああ、手段が目的になっちゃうんだ。
そうです。
スピーカー 2
時間を区切って、広く集めるときはTier2のディープリサーチを使い、集めた資料を深く正確に読み解くときはクローストラグ環境に持ち込む。
この往復を意識することが不可欠なんですよ。
スピーカー 1
いや、今日のお話でリサーチの全体像がすごくクリアになりました。
AIは私たちの能力を魔法みたいに拡張してくれるけど、決して人間の判断力を代替するものではないんですね。
その通りです。
スピーカー 1
目的別にツールを使い分けて、作話のメカニズムをちゃんと理解して、シフトメソッドやクローストラグを駆使する。
それで初めて安全で高度な情報収集ができるんだと。
スピーカー 2
自動化の恩恵を最大限に受けながらも、最終的な手綱は人間が握り続ける。これが2026年現在のベストプラクティスですね。
スピーカー 1
なるほど。ありがとうございます。
さて、今回の深掘りもそろそろ終わりですが、最後にあなたに一つ、頭の片隅に置いておいてほしい問いがあります。
もし近い未来、インターネットの海がGEOによって、AIが読みやすいようにAIによって書かれた情報で完全に埋め尽くされていくとしたら、一体どうなるでしょうか。
やがてAIが別のAIの作ったデータを延々と学習し続ける閉じたエコシステムの中で、最後に本当の価値を持つのは、もはや情報そのものではなくなるはずです。
それはきっと、提示された膨大な情報を疑い、検証し、点と点をつないで真の文脈を見出すことのできる、あなた自身の人間的な批判的思考力という極めてプレミアムな能力なのかもしれません。
スピーカー 2
次にあなたがAIエージェントにリサーチを頼むとき、あなたは自動運転車の運転席の主導権を誰に握らせますか。
今回の徹底分析はここまでです。あなたの次なる探求が、より深い洞察につながることを願っています。
20:30

コメント

スクロール